Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Suchst du einen professionellen Data Annotator, der deine komplexen Datensätze für Computer Vision, Roboter-Trennung oder Machine-Learning-Modelle labelt? Dann bist du hier richtig!
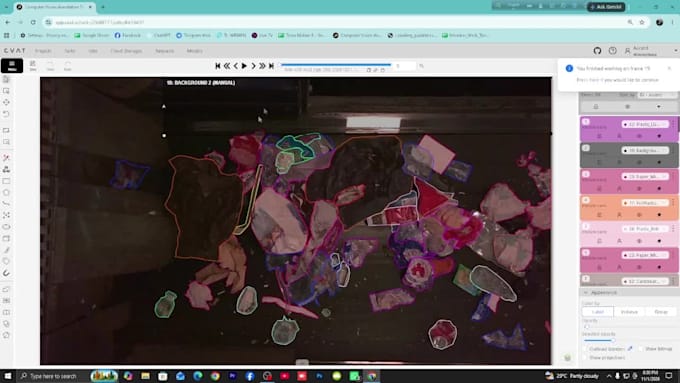
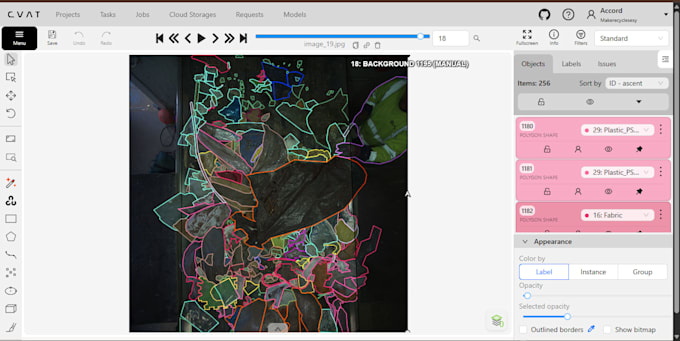
Ich spezialisiere mich auf hochwertige Datenannotation und komplexe Bildsegmentierung mit CVAT (Computer Vision Annotation Tool). Ich habe praktische Erfahrungen in fortgeschrittenen Projekten, darunter Förderband-Abfalltrennung, Recycling-Klassifizierung und dichte Objekterkennung.
Meine Services umfassen:
Branchenspezifische Erfahrung:
Tools & Formate, die ich liefere:
Warum du mich wählst?
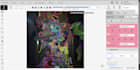
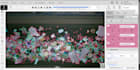
_ygi58a.jpg)

Automatische Übersetzung
Welche Tools verwendest du für die Datenannotation?
Ich nutze hauptsächlich CVAT (Computer Vision Annotation Tool) für alle Annotation- und Segmentierungsaufgaben. Falls dein Projekt jedoch andere Tools erfordert, kann ich auch mit Roboflow, Labelme und LabelImg arbeiten.
Kannst du große Datensätze und komplexe Segmentierungen bewältigen?
Ja, absolut! Wie du in meinem Portfolio siehst, habe ich praktische Erfahrungen mit sehr dichten und unübersichtlichen Bildern (z. B. Förderband-Abfalltrennung und Recycling-Datensätze) mit mehr als 100 überlappenden Objekten pro Frame.
Welche Ausgabeformate kannst du liefern?
Ich kann die annotierten Daten in nahezu jedem für deine KI-Modelle benötigten Format liefern, einschließlich CVAT XML, COCO JSON, YOLO (.txt), Pascal VOC (.xml) und Pixel-Segmentierungs-Masken (PNG/TIFF).
Wie sicherst du die Qualität und Genauigkeit des Datensatzes?
Ich führe bei jedem einzelnen Bild eine strenge Double-Check-Qualitätskontrolle durch. Ich achte darauf, dass die Polygongrenzen pixelgenau sind und kein wichtiges Objekt übersehen wird, um die besten Trainingsdaten für deine ML-Modelle zu liefern.
Nimmst du benutzerdefinierte Aufträge für große Projekte an?
Ja, ich nehme benutzerdefinierte Aufträge an. Wenn du Tausende von Bildern oder lange Videodateien hast, schicke mir bitte eine Nachricht mit deinen Projektinformationen, und ich erstelle dir ein maßgeschneidertes Angebot mit fairem Preis und Zeitplan.