Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Senior Data Engineering und Analytics Experte
Brauchst du eine skalierbare ETL/ELT-Pipeline oder eine Medallion Lakehouse-Lösung in Azure Databricks?
Ich werde Datenpipelines in Azure Databricks mit PySpark, Spark SQL, Delta Lake und modernen Data-Engineering-Praktiken bauen und optimieren.
Ich kann bei folgendem helfen:
Azure Databricks ETL/ELT-Pipelines
PySpark- und Spark SQL-Transformationen
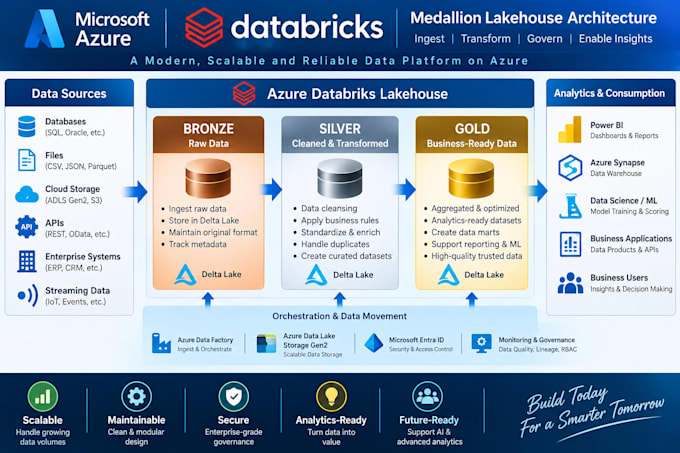
Bronze-, Silver- und Gold-Medallion-Architektur
Delta Lake Tabellen und Datenverarbeitung
ADLS Gen2 Datenintegration
Datenbereinigung, Transformation und Aggregation
Datenqualitätsprüfungen und Validierung
Pipeline-Fehlerbehebung und Optimierung
ADF-orientiertes Orchestrationsdesign
Dokumentation und Implementierungsrichtlinien
Mein Ansatz
Ich konzentriere mich darauf, wartbare, skalierbare und gut strukturierte Datenlösungen zu entwickeln, anstatt nur Code zu schreiben. Ich prüfe deine Datenquellen, Geschäftsregeln, Transformationen, erwartete Ausgaben und technische Anforderungen, bevor ich die Lösung entwerfe.
Vor der Bestellung: Bitte kontaktiere mich für komplexe oder produktive Workloads und teile deine Datenquellen, erwartete Ausgaben, Zielarchitektur, Transformationsanforderungen und Details zur Azure-Umgebung mit.

Expertise:
Automatisierungen
•
Andere
Cloud-Provider:
microsoft azure
Automatische Übersetzung
FAQ 1 — Bei welchen Arten von Azure Databricks-Projekten kannst du helfen?
Ich kann bei ETL/ELT-Pipelines, PySpark- und Spark SQL-Transformationen, Delta Lake-Verarbeitung, Medallion Bronze-Silber-Gold-Architektur, Datenqualität, Validierung, Fehlerbehebung und Leistungsoptimierung unterstützen.
FAQ 2 — Kannst du Bronze-, Silber- und Gold-Medallion-Pipelines bauen?
Ja. Ich kann Medallion-Pipelines entwerfen und bauen, bei denen Bronze Rohdaten speichert, Silber Bereinigungen und Transformationen anwendet und Gold geschäftsbereite Datensätze für Analysen und Berichte vorbereitet.
FAQ 3 — Mit welchen Technologien kannst du für diesen Service arbeiten?
Je nach Projekt kann ich mit Azure Databricks, PySpark, Spark SQL, Delta Lake, ADLS Gen2, Azure Data Factory, SQL und Python arbeiten.
FAQ 4 — Kannst du Azure Data Factory mit Databricks integrieren?
Ja. Ich kann ADF-orientierte Orchestrationsdesigns unterstützen, um Daten zu ingestieren, Databricks-Verarbeitung auszulösen, Abhängigkeiten zu verwalten und End-to-End ETL/ELT-Workflows zu unterstützen.
FAQ 5 — Kannst du eine bestehende PySpark- oder Databricks-Pipeline optimieren?
Ja. Ich kann Transformationen, Joins, Partitionierung, Caching, Shuffle-Verhalten, Delta-Tabellendesign und andere relevante Bereiche überprüfen, um geeignete Leistungsverbesserungen zu identifizieren.
FAQ 6 — Brauchst du Zugriff auf meine Azure- oder Databricks-Umgebung?
Nicht immer. Für einige Projekte können Code, repräsentative Daten, Architekturdetails, Anforderungen und erwartete Ausgaben ausreichen. Der Zugriff auf die Umgebung kann bei Bedarf bei der Umsetzung oder beim Testen besprochen werden.
FAQ 7 — Kannst du an großen oder produktiven Databricks-Projekten arbeiten?
Ja, aber bitte kontaktiere mich vor der Bestellung. Projekte mit mehreren Datenquellen, komplexen Transformationen, Produktionseinführungen, Sicherheitsanforderungen, Orchestrierung oder großen Workloads erfordern möglicherweise einen individuellen Umfang und Angebot.