Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
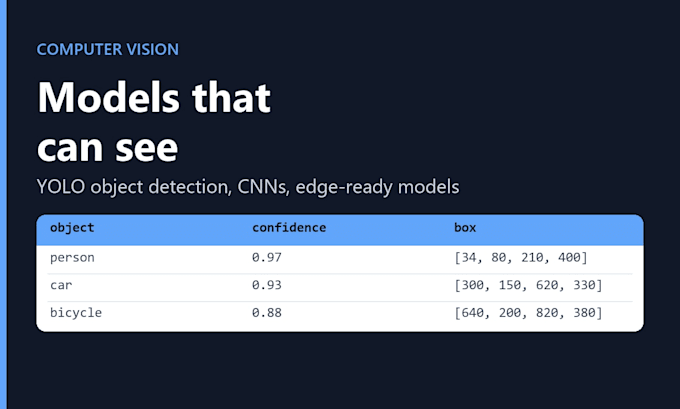
Möchtest du Software, das sehen oder hören kann? Ich erstelle maßgeschneiderte Computer-Vision- und Audio-Modelle, die auf deinen eigenen Daten trainiert werden, nutze dabei die Architektur, die am besten zu deinem Problem passt.
Was ich baue:
- Objekterkennung: Objekte zählen, lokalisieren und verfolgen (YOLO, Faster R-CNN, DETR, SSD oder jedes andere Modell)
- Bildklassifikation und eigene CNNs (Defekte, Produkte, Pflanzen, Dokumente, medizinische Bilder)
- Segmentierung und maßgeschneiderte visuelle Modelle für deinen konkreten Anwendungsfall
- Audio-Klassifikationsmodelle
- Kleine, schnelle Modelle für Handys, Raspberry Pi und andere Edge-Geräte (ONNX, TFLite, Quantisierung)
Was du bekommst:
- Ein trainiertes Modell, getestet mit deinen Daten, plus ein ehrliches Genauigkeitsbericht
- Sauberer Python-Code (PyTorch oder TensorFlow) und ein einfaches Script oder eine App, um es auszuführen
- Beratung beim Sammeln und Labeln von Daten, falls du noch keine hast
Ich habe einen M.Sc. in Data Science und spezialisiere mich auf Deep Learning und Computer Vision.
Kontaktiere mich VOR der Bestellung mit Beispielbildern und darüber, was das Modell erkennen soll. Ich sage dir, was realistisch ist und welches Paket passt.
Programmiersprache:
Python
•
Colab
Tools:
Jupyter-Notizbuch
•
opencv
•
tensorflow
•
CVAT
•
Colab
Frameworks:
scikit-learn
•
keras
•
PyTorch
Automatische Übersetzung
Brauche ich beschriftete Daten?
Nicht immer. Für einfache Aufgaben reicht ein vortrainiertes Modell aus; ansonsten helfe ich dir beim Labeln eines kleinen Datensatzes.
Kann es auf einem kleinen Gerät laufen?
Ja. Das Premium-Paket optimiert das Modell für Edge-Geräte wie Raspberry Pi oder ein Smartphone.
