Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Data Engineer oder Pipeline Data Architect
Auf der Suche nach einer skalierbaren, zuverlässigen und produktionsreifen Datenpipeline für dein Unternehmen? Ich kann helfen.
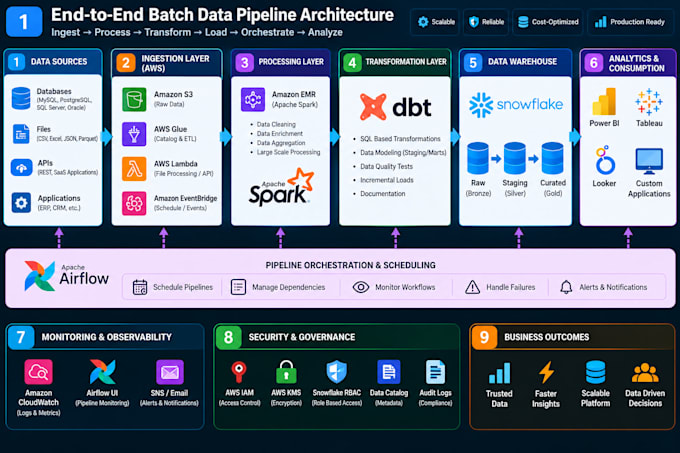
Ich bin ein unabhängiger Data Engineer und spezialisiere mich darauf, End-to-End-Cloud-Datenpipelines zu bauen, die deine Daten effizient bewegen, transformieren, orchestrieren und organisieren.
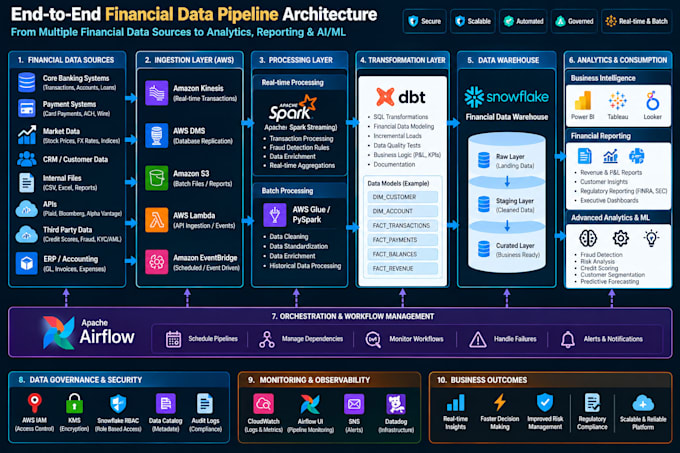
Ich kann komplette Data-Engineering-Lösungen entwerfen und implementieren, einschließlich Data Ingestion, ETL/ELT-Pipelines, Daten Transformation, Workflow-Orchestrierung, verteilte Datenverarbeitung und Cloud-Daten-Warehousing.
Mein Kern-Stack umfasst AWS, Snowflake, dbt, Apache Spark, Databricks und Apache Airflow. Ich fokussiere mich darauf, Lösungen zu schaffen, die automatisiert, wartbar, skalierbar und um deine spezifischen Geschäftsanforderungen herum gestaltet sind.
Egal, ob du eine neue Datenpipeline von Grund auf neu brauchst, einen bestehenden Workflow modernisieren, mehrere Datenquellen verbinden oder eine cloudbasierte Datenplattform aufbauen willst — ich entwickle eine Lösung von Anfang bis Ende.
Lass uns deine Rohdaten in eine zuverlässige, gut organisierte und analytikbereite Datenplattform verwandeln.
Automatische Übersetzung
Welche Arten von Datenpipelines kannst du bauen?
Ich kann End-to-End ETL/ELT-Pipelines für Batch- oder nahezu Echtzeit-Daten erstellen, einschließlich Data Ingestion, Transformation, Verarbeitung, Orchestrierung und Cloud-Daten-Warehousing.
Mit welchen Technologien arbeitest du?
Mein primärer Stack umfasst AWS, Snowflake, dbt, Apache Spark, Databricks und Apache Airflow.
Kannst du eine Datenpipeline von Grund auf neu erstellen?
Ja. Ich kann eine vollständige Pipeline basierend auf deinen Datenquellen, Geschäftsanforderungen, Architektur und Skalierbarkeitsbedürfnissen entwerfen und implementieren.
Kannst du mit meiner bestehenden data pipeline arbeiten?
Ja. Ich kann bestehende Pipelines debuggen, optimieren, automatisieren und verbessern, um Zuverlässigkeit, Leistung und Wartbarkeit zu erhöhen.
Können Sie mehrere Datenquellen verbinden?
Ja. Ich kann Pipelines entwerfen, die Daten aus Datenbanken, Dateien, Cloud-Speicher, APIs und anderen unterstützten Quellen einlesen und verarbeiten.
Wird die Lösung skalierbar sein?
Ja. Ich folge skalierbarer Cloud-Architektur und entwerfe Pipelines, die mit steigendem Datenvolumen und Verarbeitungsanforderungen umgehen können.
Stellen Sie Unterlagen zur Verfügung?
Ja. Ich kann klare Dokumentationen zu Pipeline-Architektur, Workflow, Konfiguration und Deployment bereitstellen.
Was benötigen Sie von mir, um zu beginnen?
Ich benötige deine Projektanforderungen, Datenquellen, erwartete Ausgabe, bevorzugte Cloud-Umgebung sowie vorhandene Architektur oder Code, mit dem ich arbeiten soll.