Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Automatische Übersetzung
Dein RAG-Chatbot sah im Demo-Teil gut aus. Dann fragten echte Nutzer echte Fragen – und jetzt gibt er mit voller Überzeugung falsche Antworten.
In der Regel ist nicht das Modell das Problem. Es sind Retrieval, Chunking oder OCR-fehlerhafter Text. Ich finde heraus, welches da hakt – mit Messungen statt Vermutungen.
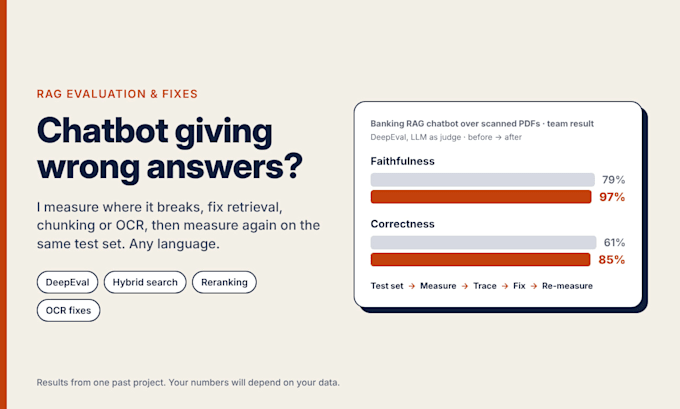
Das ist die Arbeit, in der ich am besten bin. Bei einem Banking-Chatbot auf Basis gescannter PDFs bei GBG messen wir die Treue bei 79 %. Nachdem wir OCR repariert und Hybrid-Suche, Neu-Ranking und Abfrage-Neukodierung eingeführt haben, erreichte er 97 % und die Korrektheit stieg von 61 % auf 85 % (DeepEval, LLM als Beurteiler).
So funktioniert es:
1. Ich erstelle einen Testdatensatz aus deinen Dokumenten und echten Nutzerfragen
2. Ich bewerte Treue, Korrektheit und Retrieval-Qualität
3. Ich verfolge jeden Fehler auf seine Ursache: Parsing, Chunking, Suche, Ranking oder Prompt
4. Du bekommst einen Fix-Plan, oder ich behebe die Punkte und bewerte sie erneut
Du erhältst einen kurzen Bericht mit Vorher-Nachher-Zahlen auf demselben Testdatensatz. Ich verspreche keine feste Zahl, da sie von deinen Daten abhängt.
Funktioniert mit LangChain, LlamaIndex oder reinen Python-Pipelines, in jeder Sprache, in der deine Dokumente vorliegen.
Schick mir ein paar Beispiele schlechter Antworten. Das reicht oft schon, damit ich dir sage, wo ich zuerst schauen würde.
AI Engineer building RAG systems, LLM agents and Arabic NLP
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Benötigen Sie Zugriff auf meinen Code?
Für das Audit reicht ein funktionsfähiger API-Endpunkt oder Lesezugriff. Um die Fixes zu machen, brauche ich den Code, idealerweise ein privates Git-Repo, zu dem du mich einlädst. Production-Passwörter brauche ich nicht.
Kannst du eine bestimmte Genauigkeitszahl versprechen?
Nein, und damit würde ich auch vorsichtig umgehen. Es hängt von deinen Dokumenten und Fragen ab. Was ich verspreche, sind ehrliche Vorher- und Nachher-Werte auf demselben Testset, damit du genau siehst, was sich verbessert hat.
Welche Tools nutzt du für die Evaluation?
Zum Großteil DeepEval mit einem LLM als Beurteiler, plus Checks, ob die richtigen Abschnitte abgerufen wurden. Wenn du schon RAGAS oder deine eigene Infrastruktur nutzt, arbeite ich damit.
Macht die Sprache meiner Dokumente einen Unterschied?
Der Prozess bleibt der gleiche. Die Sprache beeinflusst meist OCR, Textaufteilung und Suchqualität – darauf prüfe ich das Spektrum. Am meisten Erfahrung habe ich mit Arabisch und Englisch. Sag mir deine Sprache, und ich sage ehrlich, ob es passt.
Was, wenn die echte Lösung eine andere Architektur braucht?
Dann sagt der Bericht das, mit einer groben Schätzung, bevor ich Code schreibe. Du entscheidest, wie es weitergeht.
