Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Dateningenieur
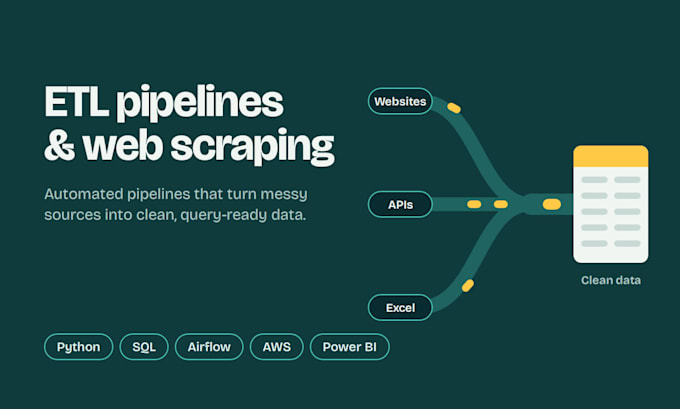
Du brauchst Daten von Webseiten oder hast Daten, aber kein verlässliches System, sie zu bewegen? Tabellenkalkulationen, APIs und Datenbanken, die nie zusammenpassen, Berichte, die jede Woche manuell neu erstellt werden, Pipelines, die über Nacht brechen? Das erledige ich.
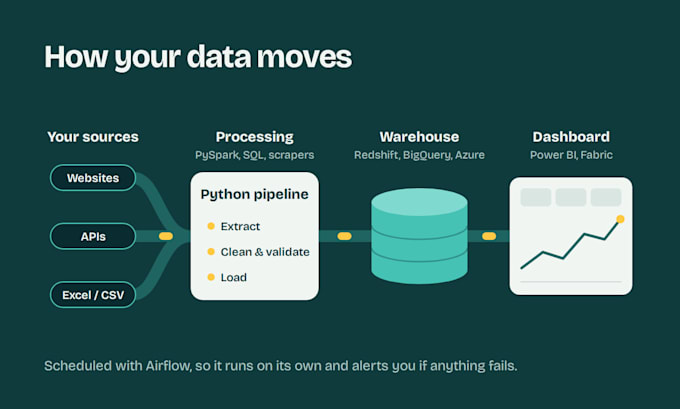
Ich bin Data Engineer mit 4 Jahren Erfahrung und MSc in Big Data Analytics aus dem Vereinigten Königreich. Derzeit baue ich Produktionspipelines für große Online-Marktplätze, einschließlich inkrementeller Redshift-Fakten-Tabellen mit über 20 Mio. Datensätzen.
Was ich baue:
Warum ich? echte Produktionserfahrung, sauberen dokumentierten Code, den du besitzt, und klare Updates in jedem Schritt.
Bitte schreib mir vor dem Bestellen, damit ich dein Projekt richtig einschätzen kann.
Automatische Übersetzung
Mit welchen Tools arbeiten Sie?
Python, SQL, PySpark, Apache Airflow, Matillion, Talend, AWS (Redshift, Lambda), Azure, Google BigQuery und Power BI sowie BeautifulSoup, Requests, Selenium, Scrapy und Playwright für Web Scraping.
Kannst du Webseiten scrapen, die Inhalte per JavaScript laden?
Ja. Für dynamische Seiten verwende ich Browser-Automatisierungstools wie Selenium oder Playwright statt einfacher Seitenanfragen.
Kannst du mit meiner bestehenden Pipeline arbeiten?
Ja. Ich kann Pipelines debuggen, optimieren oder erweitern, die du bereits hast, einschließlich Duplikate oder fehlende Datensätze zu beheben.
In welchem Format erhalte ich meine Daten?
CSV, Excel, JSON, Google Sheets oder direkt in deine Datenbank oder dein Data Warehouse geladen.
Gehört mir der Code?
Ja. Du erhältst den vollständigen Quellcode, und Standard und Premium beinhalten auch Dokumentation.
Scrapen Sie Websites?
Ich scrape ausschließlich öffentlich verfügbare Daten. Ich scrape keine Social-Media-Plattformen oder Inhalte hinter einem Login ohne Erlaubnis, da dies gegen die Fiverr-Regeln verstößt.
Kannst du Echtzeit-Pipelines bauen?
Geplante Batch-Pipelines sind mein Kerngeschäft. Für Echtzeit-Bedarf schreib mir zuerst, und wir prüfen, ob es passt.