Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD

Automatische Übersetzung
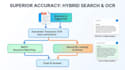
WAS DU BEKOMMST: Fortschrittliche Hybrid-Suche: Kombiniert BM25-Schlüsselwortsuche mit neuronaler Neuausrichtung (Cohere) für maximale Retrieval-Genauigkeit.
Unterstützung für gescannte PDFs: Automatisches Umschalten auf Tesseract OCR bei bildlastigen oder gescannten Dokumenten.
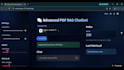
Individuelle Benutzeroberfläche: Modernes, responsives Streamlit-Dashboard mit anpassbaren dunklen/navy Themen und Hyperparameter-Steuerung.
Inline-Quellenangaben: Präzise Antwortgenerierung mit direkten Dateinamen- und Seitenzuweisungen.
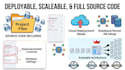
Sauberer Quellcode: Vollständig dokumentierter, modularer Python-Code, bereit für Cloud-Deployment.
TECH STACK: Python | Streamlit | PyMuPDF | Tesseract OCR | OpenAI API | Cohere | Vektor-Datenbanken
Sende mir eine Nachricht oder place deine Bestellung noch heute, um deine komplexen Dokumente in einen interaktiven KI-Assistenten zu verwandeln!
Live-Demo-Vorschau verfügbar!
Sende mir eine Nachricht, um die interaktive Streamlit RAG-App in Echtzeit zu testen
Python Developer for RAG Chatbots, LangChain, and AI Agents
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Brauche ich eigene API-Schlüssel?
Ja, du benötigst deine eigenen Groq- und Cohere-API-Schlüssel, die kostenlos erhältlich sind. Ich werde dich bei der Einrichtung anleiten.
Kann dieser Prozess gescannte Bild-PDFs verarbeiten?
Ja, die App beinhaltet einen automatischen Tesseract OCR-Fallback, um Text aus gescannten Dokumenten zu extrahieren und zu indexieren.


