Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
AI-Entwickler, DeepSeek, AI-Agenten, Automatisierung
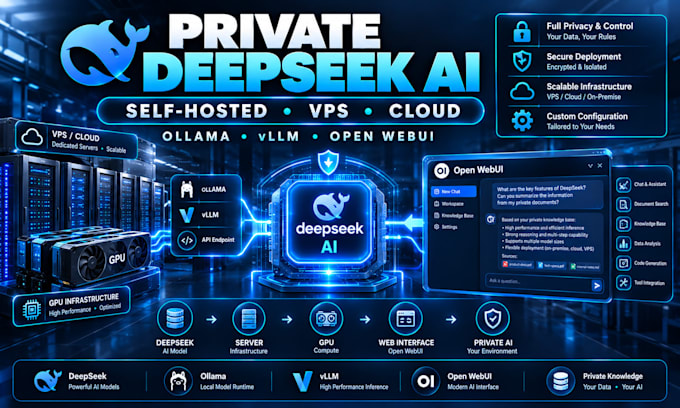
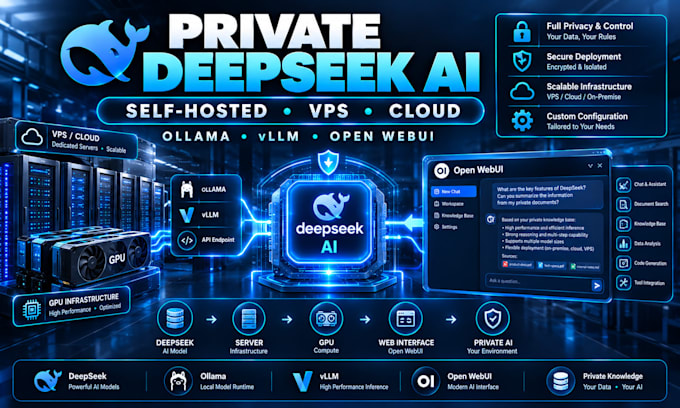
Möchtest du DeepSeek AI privat auf deinem eigenen Server laufen lassen, anstatt vollständig auf externe KI-Dienste zu vertrauen?
Ich werde eine private DeepSeek AI Umgebung auf deinem VPS, Cloud-Server, Arbeitsplatz oder kompatibler Infrastruktur bereitstellen und konfigurieren.
Ich kann das KI-Modell, die Weboberfläche, API-Zugang, Sicherheitskonfiguration und unterstützende Infrastruktur nach deinen Anforderungen einrichten.
WAS ICH EINRICHTEN KANN
DeepSeek AI Deployment
Private/self-hosted AI
DeepSeek auf VPS oder Cloud-Server
Ollama Deployment
vLLM Deployment
Open WebUI Integration
DeepSeek API-Endpunkt
GPU/Modell-Konfiguration
AI-Server-Konfiguration
Private AI-Arbeitsumgebung
RAG-fertige Infrastruktur
Leistungsoptimierung
Sicherheits- und Zugriffsverwaltung
PRIVATE AI INFRASTRUKTUR
Deine Deployment kann für Organisationen konfiguriert werden, die mehr Kontrolle über ihre AI-Umgebung und Daten wünschen.
Je nach deiner Infrastruktur kann ich konfigurieren:
Linux/VPS-Server
Cloud-Infrastruktur
GPU-Server
Lokale Arbeitsstationen
Docker-basierte Deployment
Open WebUI
Ollama oder vLLM
HTTPS/SSL
Authentifizierung
API-Zugang
Lass uns deine private DeepSeek AI Umgebung aufbauen.
Cloud-Provider:
Oracle Cloud
Expertise:
Installation
•
Backup
•
Migration
•
Debuggen
•
Entwicklung
Cloud-Computing-Ressource:
ELB
•
Route53
•
VPC
•
Security Groups
•
DNS
Automatische Übersetzung
Brauche ich meinen eigenen VPS oder Server?
Ja. Du brauchst einen kompatiblen VPS, Cloud-Server, Arbeitsplatz oder lokalen Rechner. Schick mir deine Spezifikationen vor der Bestellung, damit die Kompatibilität geprüft werden kann.
Kannst du DeepSeek auf meinem VPS bereitstellen?
Ja. Ich kann DeepSeek auf einem kompatiblen VPS oder Cloud-Server bereitstellen und konfigurieren, inklusive benötigtem Runtime und Webinterface.
Kannst du Ollama oder vLLM verwenden?
Ja. Ollama und vLLM können je nach Hardware, Modell und Leistungsanforderungen genutzt werden. vLLM ist für Hochdurchsatz-Inferenz ausgelegt.
Kann ich die Deployment mit n8n, APIs oder meiner Anwendung verbinden?
Ja. API-Zugang kann für kompatible Automatisierungs-Workflows, Anwendungen, Bots und andere Dienste eingerichtet werden.
Kannst du auch andere Open-Source-KI-Modelle bereitstellen?
Ja, wo es technisch sinnvoll ist. Der Service kann an kompatible lokale Model-Runtimes und Infrastruktur angepasst werden.