Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Automatische Übersetzung
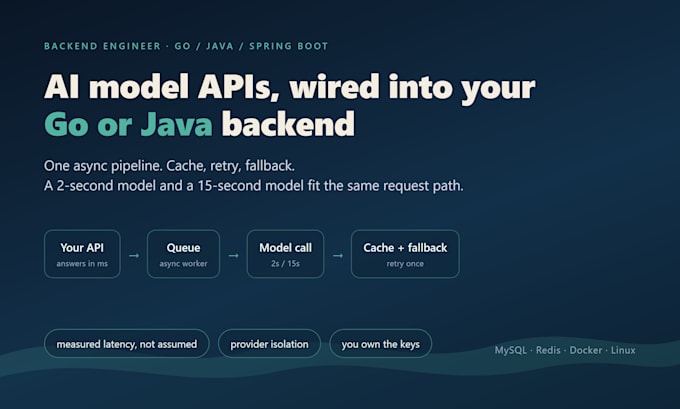
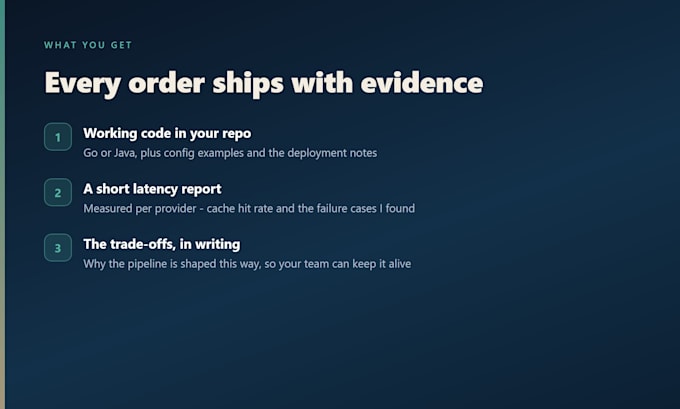
Du möchtest eine KI-Funktion in deinem Backend, die echten Nutzern standhält – nicht nur ein Demo-Notebook. Ich bin Backend-Entwickler (Go / Java / Spring Boot). Ich habe die Produktionsversion gebaut: drei Modelle hinter einer einzigen asynchronen Pipeline, einem Cache davor und einer Anbieter-Schnittstelle, die so schlank ist, dass Vendor-Wechsel nur eine Konfiguration erfordert. Was ich mache: - Modell-APIs hinter einer einzigen asynchronen Pipeline: Ein 2-Sekunden- und ein 15-Sekunden-Modell passen auf denselben Weg, und die Seite wartet nie - Cache + Retry + Fallback: einmal versuchen, dann den nächsten Anbieter - Anbieter-Isolation: eine Schnittstelle, ein Adapter pro Anbieter, kein Vendor-SDK im Domain-Code - Latenz-Budget explizit gemacht: gemessen, nicht angenommen Was du bekommst: - Funktionierenden Code in deinem Repo (Go oder Java), plus Konfig-Beispiele - Einen kurzen Bericht: gemessene Latenz pro Anbieter, Cache-Hit-Rate, Fehlerfälle - Deployment-Hinweise und die Trade-offs, schriftlich Was ich brauche: - Wo der Code liegt und wie er deployed wird - Welche Anbieter du nutzt und die API-Schlüssel (deine – du zahlst dafür) - Einen guten Output und einen schlechten Output; mehr wert als eine Spezifikation Passt nicht, wenn du ein Modell von Grund auf trainieren musst, RAG über einen großen Korpus brauchst oder eine reine Frontend-Integration. Schreib mir zuerst.
Backend Engineer
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Verwendest du RAG oder Vektor-Datenbanken?
Nicht in diesem Gig. Ich integriere Modell-APIs defensiv: eine async-Pipeline, eine Anbieter-Schnittstelle, plus Cache, Retry und Fallback. Wenn du eine Abfrage über einen großen Korpus mit einem Eval-Set brauchst, ist das ein anderes Scope, und ich sage das ehrlich.
Wer stellt die API-Schlüssel für die KI bereit?
Du – du besitzt das Konto und zahlst dafür. Ich richte die Integration ein und halte die Schlüssel in der Konfig oder einem Secret Store, niemals im Repo hardcoded.
In welchen Sprachen und Frameworks arbeitest du?
Go und Java (Spring Boot) für das Backend, plus MySQL, Redis, Docker und Linux in der Produktion. Frontend-Arbeiten sind nicht das Ziel dieses Gigs.
Kannst du die Qualität der Modellausgabe garantieren?
Nein, und das werde ich auch nicht vortäuschen. Ich mache die Pipeline zuverlässig und messbar: Timeouts, Retry, Fallback, gecachte Aufrufe und eine echte Latenz pro Anbieter. Die Qualität der Ausgabe ist eine Prompt- und Anbieterfrage, die wir gemeinsam abstimmen.