Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
KI-Ingenieur für Computer Vision und LLM-Apps
Schlechte Daten sind der häufigste Grund, warum ein Erkennungsmodell versagt. Ich bereinige, konvertiere und überprüfe dein Objekt-Erkennungs-Dataset, damit es bereit für das Training ist.
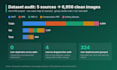
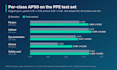
Hintergrund: Für mein PPE-Sicherheits-Erkennungsprojekt habe ich 5 öffentliche Quellen zu einem sauberen Dataset mit 6956 Bildern zusammengeführt: einheitliche Klassenbezeichnungen, Duplikate entfernt, Leckagen zwischen Training und Test geprüft und fehlerhafte Labels korrigiert. Zusammen mit Methodenvergleichen stieg der mAP50 von 0.674 auf 0.753 auf einem Testset mit 808 Bildern.
Ich kann:
Was du bekommst:
Hinweis: Neue Labels von Grund auf neu zu zeichnen, ist nicht enthalten. Schreib mir für ein Angebot.
Technik:
Automatisiert
Tagging-Typ:
Bild
•
Video
Automatische Übersetzung
Labelst du neue Bilder?
Nein, in diesem Gig nicht. Ich repariere, konvertiere und überprüfe bestehende Labels. Neue Annotationen von Grund auf werden separat angeboten, schreib mir mit deinem Volumen.
Werden meine Daten vertraulich behandelt?
Ja. Ich verwende deine Daten nur für deinen Auftrag, teile sie niemals und lösche sie nach Lieferung, wenn du es wünschst.
Welche YOLO-Versionen werden unterstützt?
Das YOLO TXT-Format funktioniert mit YOLOv5, YOLOv8 und YOLO11 (Ultralytics). Ich liefere auch eine fertige data.yaml Datei.
Kannst du Exporte von Roboflow, CVAT oder Label Studio umwandeln?
Ja. Schick mir den Export so, wie er ist (YOLO TXT, COCO JSON, Pascal VOC XML, CVAT oder Label Studio). Ich konvertiere ihn in dein Ziel-Format, überprüfe, ob jede Box noch zu ihrem Bild passt, und gebe dir eine data.yaml, die bereit für das Ultralytics-Training ist.
Wie findest du schlechte Labels?
Zuerst automatische Checks: Boxen außerhalb des Bildes, nullgroße oder doppelte Boxen, unbekannte Klassen-IDs, leere Label-Dateien und exakt oder fast doppelte Bilder über die Splits hinweg. Danach schaue ich mir eine visuelle Stichprobe jeder Klasse an. Du bekommst eine CSV, in der alle gefundenen Probleme aufgelistet sind.


