Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Automatische Übersetzung
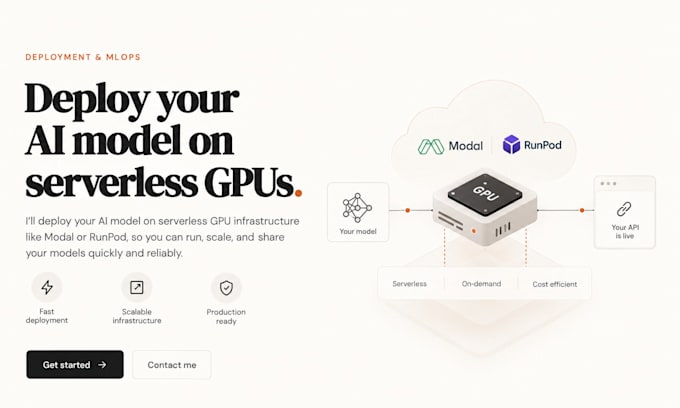
Ich entwickle und optimiere AI-Inference-Backends für Apps, die echte GPU-Rechenleistung brauchen, nicht nur eine Hülle um die ChatGPT-API.
Ich habe Produktions-AI-Pipelines (Bild-/Videoverarbeitung, Face-Swap-Style generative Modelle) auf Modal's serverless GPU-Infrastruktur bereitgestellt und optimiert, inklusive:
- GPU/CPU-Instanzkonfiguration (L4/T4), abgestimmt auf Kosten versus Latenz
- Kaltstart- und Warmup-Optimierung, um verschwendete GPU-Sekunden zu reduzieren
- GPU-Speicherabbildung, um die Kaltstartzeit zu verkürzen
- Pipeline-Optimierung, etwa 75% Reduktion der Verarbeitungszeit bei einer Produktionslast
- Signalbehandlung und Zuverlässigkeitsverbesserungen für lang laufende Inference-Jobs
Mobile App Developer
Sprachen
Automatische Übersetzung
