Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Computer Vision Engineer, YOLO und Echtzeit-Deployment
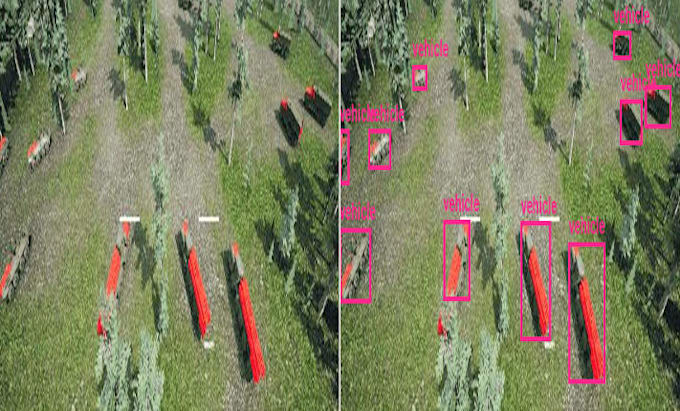
Genaue Bounding-Box- und Polygon-Annotationen für Computer-Vision-Trainingsdaten, geliefert im Format, das deine Pipeline erwartet.
Ich bin ein Computer-Vision-Ingenieur, kein Labeling-Auftragnehmer. Das zeigt sich bei Randfällen: verdeckte Objekte, mehrdeutige Klassenbegrenzungen und Instanzen nahe der Auflösungsgrenze. Ich labeln so, wie ein Modell trainiert werden muss, und ich markiere die Entscheidungen, die du treffen solltest, anstatt stillschweigend zu raten.
WAS DU BEKOMMST
Bounding-Boxen oder Polygon-Segmentierungsmasken
Export im YOLO-, COCO-JSON- oder Pascal VOC-XML-Format
Klassenverteilungsübersicht, damit du vor dem Training Ungleichheiten erkennst
Hinweise zu mehrdeutigen Fällen und wie ich sie gelöst habe
Standard- und Premium-Paket beinhalten eine zweite QA-Überprüfung jeder Annotation.
Premium umfasst eine leakage-sichere Aufteilung in Train, Val und Test, gruppiert, sodass nahe Duplikate in beiden Teilen nicht landen und deine Validierungswertung verfälschen.
Video-Frame-Extraktion ist inklusive, ohne zusätzliche Kosten. Schick mir das Rohmaterial und deine Sampling-Rate.
Sende mir deine Bildanzahl und Klassenliste für ein genaues Angebot.

Technik:
Anleitung
Tagging-Typ:
Bild
•
Video
Automatische Übersetzung
Wie stellst du die Konsistenz beim Labeln von tausenden Bildern sicher?
Ich schreibe vor Beginn eine kurze Label-Richtlinie, die beschreibt, was als Instanz zählt, wie mit Occlusion umzugehen ist und die minimale Objektgröße. Diese schicke ich dir zur Freigabe. Konsistenz entsteht, indem man die Regeln einmal festlegt, nicht fallweise.
Kannst du Videos annotieren?
Ja. Schick mir das Rohmaterial und deine Sampling-Rate, und ich extrahiere Frames ohne zusätzliche Kosten. Frames aus einem Clip sind nahezu Duplikate, daher gruppiere ich sie beim Split, damit sie weder im Training noch in der Validierung landen.
Werden meine Daten vertraulich behandelt?
Ja. Deine Daten werden nur für dein Projekt verwendet, während der Arbeit lokal gespeichert und nach Wunsch nach Lieferung gelöscht. Ich bin gerne bereit, vor dem Versand eine NDA zu unterschreiben.
Was, wenn ich mit einigen Labels nicht einverstanden bin?
Schick mir die entsprechenden Dateien und erkläre, was du anders gemacht hättest. Ich überarbeite diese und aktualisiere die Richtlinie, damit die gleiche Entscheidung im Rest des Sets gilt. Revisionen sind in jedem Paket enthalten.