Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Dateningenieur
Hast du langsame Abfragen in BigQuery, defekte dbt-Modelle oder unoptimierte Spark-Jobs?
Ich bin ein Senior Data Engineer (Databricks Associate Certified) mit über 5 Jahren Erfahrung im Aufbau und der Optimierung skalierbarer Cloud-Datenarchitekturen (GCP, Databricks, BigQuery). Ich spezialisiere mich darauf, komplexe, langsame und teure Datenpipelines in schnelle, effiziente und kostengünstige Workflows zu verwandeln.
Was ich für dich tun kann:
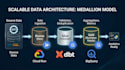
- dbt & Data Warehousing: Erstellen und Umgestalten von dbt-Modellen nach Medallion-Architektur (Bronze, Silver, Gold), SQL-Abfragen optimieren und Cloud Run / Control-M / Airflow-Ausführungen einrichten.
- PySpark & Databricks: Debuggen, umgestalten und beschleunigen von Batch-ETL-Pipelines mit Spark (Scala/Python).
- GCP Cloud-Architektur: Skalierbare Pipelines mit BigQuery, Cloud Run und Airflow/Composer einrichten.
- Datenbank- & Abfrageoptimierung: Reduzieren der Verarbeitungskosten und Ausführungszeiten bei BigQuery/Snowflake.
Warum mit mir arbeiten?
- Zertifizierte Expertise: Databricks Certified Data Engineer & Azure Certified.
- Hochwertiger Code: Saubere, modulare und wartbare Data-Engineering-Praktiken.
- Klare & direkte Kommunikation: Englisch und Spanisch verfügbar.
Hinweis: Kontaktiere mich mit deinen Anforderungen, bevor du eine Bestellung aufgibst.

Tools und Plattformen:
Google Cloud Dataflow
•
Apache NiFi
•
Andere
Automatische Übersetzung
Akzeptierst du individuelle, langfristige Aufträge?
Ja, aber nur für abgegrenzte Micro-Tasks oder Teilzeitberatung. Bitte sende mir zuerst eine Nachricht, um die Details zu besprechen.
Was muss ich vor dem Start bereitstellen?
Zugang zur Cloud-Umgebung (oder anonymisierte Beispiel-Daten/-Codebasis) und eine klare Beschreibung des erwarteten Outputs/Fehlerprotokolle.
Können wir einen Anruf planen, um das Projekt zu besprechen?
Ja, über die Videoanruf-Funktion von Fiverr, sobald eine Bestellung oder Anfrage gestartet ist.


