Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Kopieren und Einfügen aus PDFs ist nicht skalierbar, und generische OCR-Tools zerstören Tabellen. Billige Daten-Eingabe-Jobs funktionieren, solange du sie nicht wiederholbar, prüfbar und jede Woche automatisch laufen lassen willst.
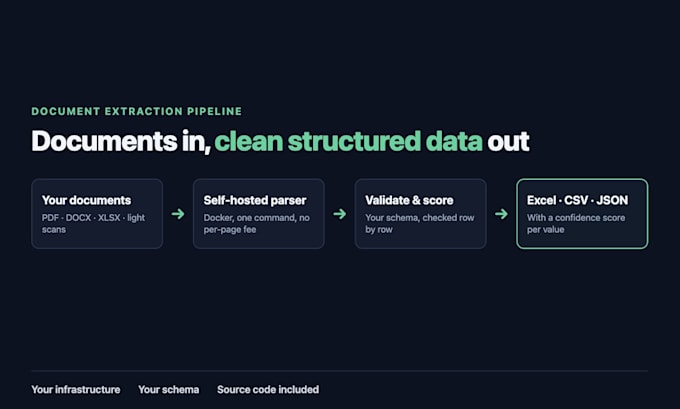
Ich baue stattdessen die Pipeline: Dokumente rein, saubere strukturierte Daten raus, auf deiner eigenen Infrastruktur.
WAS DU BEKOMMST
- Eine Pipeline, die du selbst ausführst (Docker, ein Befehl)
- Dein Schema, deine Felder, bei jedem Eintrag geprüft
- Vertrauenswürdigkeit für jeden extrahierten Wert
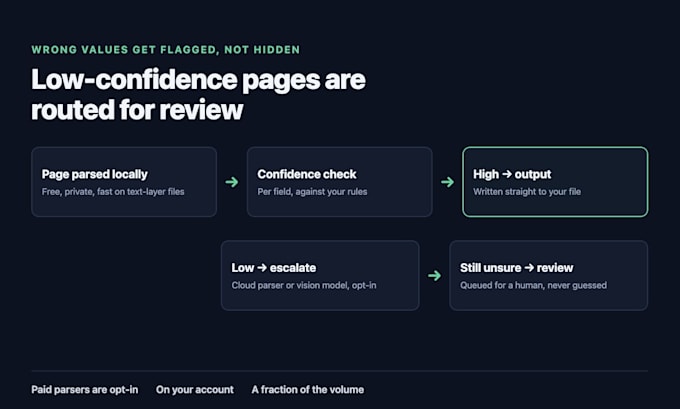
- Seiten mit niedriger Vertrauenswürdigkeit für Überprüfung, nicht stillschweigend falsch
- Excel-, CSV- oder JSON-Ausgabe
- Quellcode und Setup-Dokumentation
WARUM SELBST-HOSTEN
Der Parser läuft lokal: keine Gebühren pro Seite, und deine Dokumente verlassen nie deine Infrastruktur. Bezahldienste für Cloud-Parser werden nur für Seiten genutzt, die sie wirklich brauchen – ein Bruchteil des Volumens, auf deinem Konto, nach deinem Ermessen.
WIE ICH ARBEITE
Beginne mit dem Pilot. Schick 20-50 echte Seiten. Ich verarbeite sie und sende einen schriftlichen Bericht: Was sauber extrahiert wurde, was nicht, und welche Felder Überprüfregeln brauchen. Dann entscheidest du.
IM UMFELD
Textlayer-PDF, DOCX, XLSX, PPTX und leichte Scans. Handschrift, Formulare und Diagramme werden separat angeboten – frag einfach.
Schick 3-5 Beispielseiten und die Felder, die du brauchst.
Technologie:
Excel
•
Python
Automatische Übersetzung
Wie unterscheidet sich das von einem 20-Dollar-Daten-Eingabe-Job?
Ein Daten-Eingabe-Job verarbeitet deine Dokumente einmal. Das ist eine Pipeline, die du besitzt und immer wieder laufen lässt, mit Validierungsregeln und Vertrauenswürdigkeit, damit du siehst, welche Werte du vertrauen kannst. Das ist eine ganz andere Anschaffung.
Zahle ich pro Seite?
Nicht für den Parser – er läuft auf deinem eigenen Rechner, also ist das Seitenvolumen kostenlos. Nur Seiten, die einen Cloud-Parser oder Vision-Model benötigen, kosten etwas, auf deinem eigenen Konto, und du entscheidest, ob du das aktivierst.
Welche Genauigkeit kannst du versprechen?
Nicht, bevor ich deine Dokumente gesehen habe, und sei skeptisch bei jedem, der das behauptet. Veröffentlichte Benchmark-Tests für Parser weichen stark ab, und die Ergebnisse hängen von deinen spezifischen Layouts ab. Der Pilot misst es zuerst an deinen echten Seiten.
Verlassen meine Dokumente meine Infrastruktur?
Nicht standardmäßig. Der Parser ist self-hosted. Cloud-Parser sind optional, pro Seite, und nur für Seiten, die das lokale Pipeline als niedrig vertrauenswürdig markiert. Wenn du keine externen Aufrufe willst, sag Bescheid, und ich baue es so.
Kannst du auch gescannte Dokumente bearbeiten?
Leichte Scans, ja. Bei schweren Scans, Handschrift und Formularen, braucht es ein separates Angebot. Diese sind wirklich anspruchsvoller, und ich möchte sie ehrlich bepreisen, statt unter Wert zu liefern.
Was passiert mit Werten, die falsch sind?
Sie werden markiert, nicht versteckt. Jeder Wert hat eine Vertrauenswürdigkeit, und Zeilen mit niedriger Vertrauenswürdigkeit werden für Überprüfung herausgeleitet, anstatt stillschweigend in deine Tabelle geschrieben zu werden.
Wer führt es nach Übergabe aus?
Du. Es ist ein Docker-Container plus dein Code, mit Setup-Dokumenten. Ein Befehl zum Starten.