Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD

Automatische Übersetzung
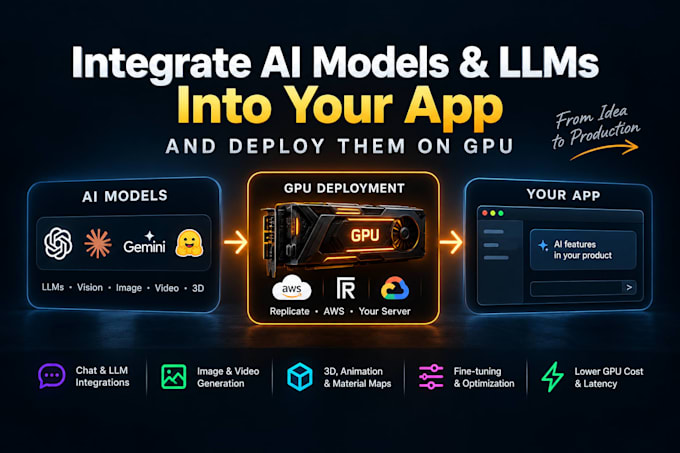
Hast du eine AI-Funktion, die in der Demo funktioniert, aber im Produktivbetrieb versagt? Ich entwickle und liefere AI-Integrationen, die auch bei echten Nutzern standhalten.
In den letzten 5 Jahren habe ich als AI-Ingenieur Produktionspipelines für Gaming und Echtzeit-3D gebaut: LLMs, Video-Matting, Kameratracking, Animationen und Material-Map-Modelle, die auf Cloud-GPUs laufen und in Live-Web-Apps integriert sind.
Was ich für dich tun kann:
- OpenAI, Claude, Gemini oder Open-Source-Modelle in deine App integrieren
- Custom- oder Hugging Face-Modelle auf Replicate, AWS oder deinem eigenen GPU-Server bereitstellen
- Generative AI-Pipelines für Bild, Video und 3D erstellen
- Bestehende Modelle auf deine Daten feinabstimmen
- Alles mit deinem Next.js-, React- oder Python-Backend verbinden
- GPU-Kosten und Latenz reduzieren
Warum ich:
Ich rufe nicht nur eine API auf. Ich habe Modelle trainiert, optimiert und in Produktion gewartet und sowohl Frontend als auch Backend integriert.
Du bekommst sauberen Quellcode, einen funktionierenden Endpoint, Dokumentation und einen Übergabegespräch.
Schreib mir vor der Bestellung eine Nachricht, mit deinem Use Case und Stack, damit ich das passende Paket empfehlen kann.
Full Stack Blockchain and Gen AI developer
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Welche KI-Modelle können Sie integrieren?
Gehostete APIs wie OpenAI, Claude und Gemini. Gehostete Plattformen wie Replicate und Hugging Face. Auch Open-Source- oder eigene PyTorch-Modelle, inklusive Bild-, Video-, LLM- und Computer-Vision-Modelle.
Brauche ich mein eigenes GPU- oder Cloud-Konto?
Nein. Ich kann auf Replicate oder AWS unter deinem Konto bereitstellen, sodass du die Infrastruktur und Abrechnung besitzt. Wenn du bereits einen GPU-Server hast, kann ich dort deployen.
Können Sie mit meiner vorhandenen Codebasis arbeiten?
Ja. Ich integriere regelmäßig in bestehende Next.js-, React- und Python-Backends und passe mich deiner Struktur an, anstatt sie neu zu schreiben.
Werde ich der Eigentümer des Codes sein?
Ja. Du erhältst vollständigen Quellcode, Deployment-Konfigurationen und Dokumentation.
Wie hältst du die GPU-Kosten niedrig?
Ich wähle die passende GPU-Stufe und nutze Queuing, Autoscaling und Cold-Start-Optimierung. Wo die Qualität es zulässt, optimiere oder quantisiere ich das Modell auch.
Kannst du ein Modell für meinen Anwendungsfall feinabstimmen?
Ja, wenn du geeignete Daten hast. Ich werde deinen Datensatz zuerst bewerten und dir ehrlich sagen, ob Feinabstimmung, ein besserer Prompt oder eine andere Pipeline die klügere Wahl ist.
