Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Die Freelance Bubble
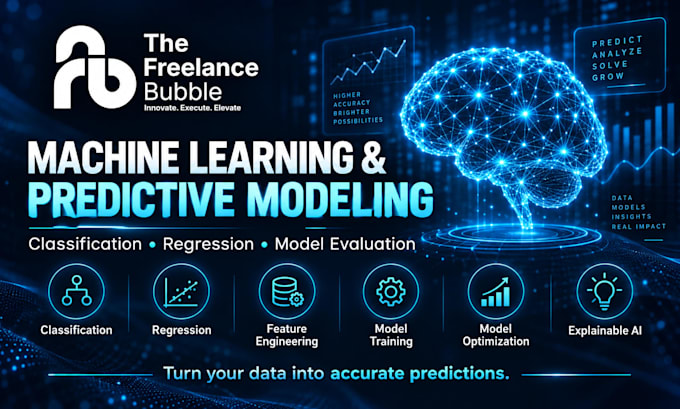
Ich erstelle präzise, interpretierbare und professionell dokumentierte Machine Learning- und Vorhersagemodelle, die auf deine Daten und Projektziele zugeschnitten sind.
Ich kann mit Forschungs-, Gesundheits-, Geschäfts-, wissenschaftlichen und strukturierten Datensätzen arbeiten, um rohe Daten in bedeutungsvolle Vorhersagen und umsetzbare Erkenntnisse zu verwandeln.
Meine Dienstleistungen umfassen:
Ich arbeite mit Python, R, Scikit-learn, TensorFlow, PyTorch, XGBoost, Jupyter, Colab und RStudio.
Bitte kontaktiere mich vor der Bestellung für Deep Learning, sehr große Datensätze, Cloud-Deployment, API-Integration oder individuelle Workflows.
Programmiersprache:
Python
•
R
•
MATLAB
•
SQL
•
Colab
Frameworks:
scikit-learn
•
keras
•
PyTorch
•
Panda
•
Andere
APIs:
Andere
Tools:
Jupyter-Notizbuch
•
tensorflow
•
Excel
•
MLflow
•
Stata
•
Colab
•
RStudio
Automatische Übersetzung
Welche Arten von Machine Learning Projekten kannst du bearbeiten?
Ich kann an Klassifikation, Regression, Clustering, Anomalieerkennung, Vorhersageanalyse, Feature Engineering, Entscheidungsbaum-Modellen und Modellebene arbeiten, sowohl für Forschungs-, Gesundheits-, Geschäfts- als auch wissenschaftliche Datensätze.
Was muss ich bereitstellen, bevor Sie beginnen?
Bitte stelle deine Datensätze, Projektziele, Zielvariable falls vorhanden, gewünschtes Ergebnis und alle spezifischen Anforderungen oder Fragen, die das Modell beantworten soll, bereit.
Welche Programmiersprachen und Tools nutzen Sie?
Ich nutze hauptsächlich Python und R mit Scikit-learn, TensorFlow, PyTorch, XGBoost, Jupyter Notebook, Colab, RStudio, SQL und verwandten Data-Science-Tools.
Stellen Sie den Quellcode zur Verfügung?
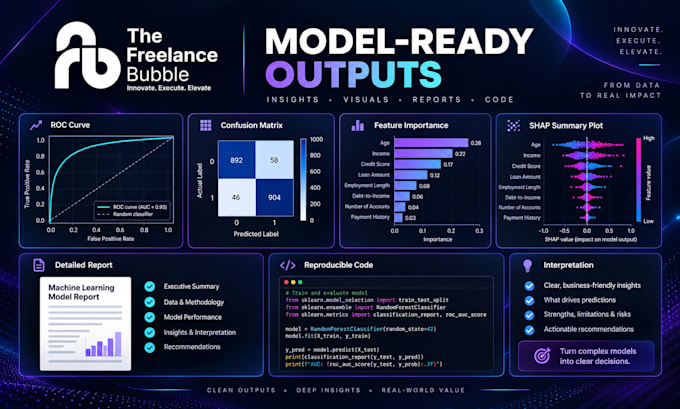
Ja. Quellcode oder Notebooks sind je nach gewähltem Paket enthalten und werden für Reproduzierbarkeit und Überprüfung organisiert.
Kannst du mehrere Machine Learning Modelle vergleichen?
Ja. Standard- und Premium-Pakete können mehrere Modelle, Kreuzvalidierung, Modellvergleich, Optimierung und Auswahl basierend auf geeigneten Leistungsmetriken enthalten.
Stellst du erklärbare KI oder SHAP-Analysen bereit?
Ja. Erklärbare KI, SHAP-Werte, Feature-Importance und Interpretation können enthalten sein, insbesondere im Premium-Paket oder durch ein individuelles Angebot.
Kannst du mit Gesundheits- oder Forschungsdaten arbeiten?
Ja. Ich kann biomedizinische, Gesundheits-, Forschungs- und wissenschaftliche Datensätze analysieren. Bitte stelle sicher, dass alle sensiblen Daten vor der Weitergabe ordnungsgemäß anonymisiert sind.
Bietest du Modellbereitstellung oder API-Integration an?
Ja, Cloud-Deployment und API-Integration können als Extras hinzugefügt oder je nach Komplexität des Projekts durch ein individuelles Angebot geregelt werden.
Kannst du eine bestimmte Modellgenauigkeit garantieren?
Nein. Die Modellleistung hängt von Datenqualität, Stichprobengröße, Klassenbalance, Relevanz der Features und dem zugrunde liegenden Vorhersageproblem ab. Ich setze auf rigorose Validierung und transparente Berichterstattung, nicht auf unrealistische Garantien.
Soll ich Sie vor der Bestellung kontaktieren?
Ja, insbesondere für große Datensätze, Deep Learning, Gesundheitsprojekte, Deployment, API-Integration oder individuelle Machine Learning-Anforderungen.