Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Generative KI Entwickler RAG, LLMs, NLP, CV, KI-Lösungen
Benötigst du Production-Grade NLP & RAG-Architektur? Hör auf, dich mit Wrappers zufriedenzugeben.
Hallo, ich bin ein KI-Ingenieur, spezialisiert auf fortschrittliches Natural Language Processing und intelligente Retrieval-Systeme. Ich schließe nicht nur einfache API-Schlüssel an; ich entwickle unternehmensgerechte, vollstacks LLM-Pipelines, optimiert für Genauigkeit und Latenz.
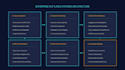
Zentrale operative Leistungen:
Lass uns veraltete Workflows abschaffen. Sende deine Datenparameter.

Automatische Übersetzung
Welche Datenformate kann deine RAG-Pipeline verarbeiten?
Ich entwickle robuste Datenaufnahme-Pipelines, die hochgradig unstrukturierte Unternehmensdaten verarbeiten können. Dazu gehören Roh-PDF-Korpora, CSV-Matrizen, JSON-Arrays und direkte Extraktion aus relationalen SQL- oder NoSQL-Datenbanken. Wenn deine Daten isoliert sind, baue ich die Extraktionsschicht, um sie zu vektorisieren.
Wie verhinderst du, dass das LLM halluciniert oder Fakten erfindet?
Ich setze strikte Retrieval-Augmented Generation (RAG)-Architekturen ein. Das LLM ist mathematisch so eingeschränkt, dass es nur auf semantische Chunks aus deiner privaten Vektordatenbank zugreift, was null Halluzinationen garantiert.
Wird meine proprietäre Firmendaten für das Training öffentlicher Modelle genutzt?
Absolute Datenkontrolle ist gewährleistet. Unternehmens-APIs garantieren, dass keine Daten für öffentliches Training gespeichert werden. Für maximale Sicherheit können wir Open-Source-Modelle vollständig lokal auf deinen air-gapped AWS/Azure-Servern bereitstellen.
Verwendest du nur Prompt-Engineering oder baust du echte Infrastruktur?
Ich bin Systemarchitekt, kein Prompt-Writer. Ich baue komplette Backend-Infrastruktur: Entwicklung von FastAPI-Knoten, Konfiguration von NoSQL-Vektordatenbanken (Chroma/Pinecone), Ausführung der Chunking-Logik und native Bindung der Retrieval-Loops.
Wo setzt du die finale KI-Anwendung ein?
Die Deployment-Strategie richtet sich nach deinem Stack. Ich containerisiere die Pipeline mit Docker für sauberes CI/CD, oder setze Inferenzknoten direkt in skalierbare Cloud-Umgebungen wie Amazon SageMaker oder Azure ML Studio ein.
Bekomme ich den vollständigen Quellcode und die technische Dokumentation?
Ja. Du erhältst den vollständigen, unverschlüsselten Python/FastAPI-Quellcode, die Datenbank-Indexierungskonfigurationen und eine umfassende Technical Architecture Definition (TAD), die alle Vektorisierungs- und API-Routing-Protokolle beschreibt.


