Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Erfahrener Data Engineer! Data Pipeline Spezialist! Data Migration
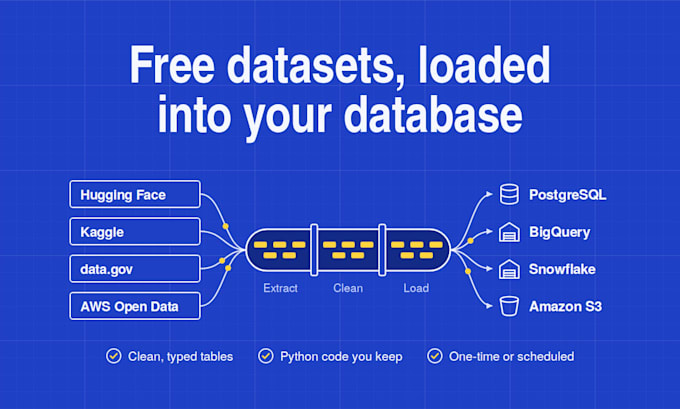
Braucht dein eine öffentliche Dataset in deiner eigenen Datenbank? Ich ziehe sie von Hugging Face, Kaggle oder einer anderen Open-Data-Quelle, bereinige sie und lade sie in deine Datenbank, dein Data Warehouse oder Cloud-Speicher, bereit zum Abfragen.
Was ich mache:
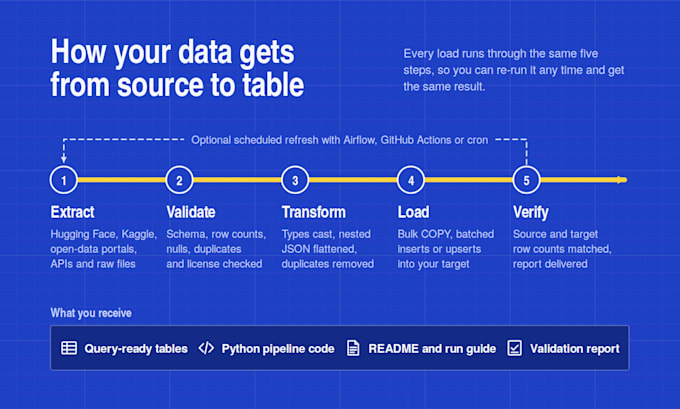
Extrahieren aus Hugging Face, Kaggle, data.gov, AWS Open Data, BigQuery-öffentlichen Datensätzen, APIs sowie CSV-, JSON- oder Parquet-Dateien
Bereinigen und transformieren: richtige Datentypen, verschachtelte JSONs flatten, Duplikate und fehlerhafte Zeilen entfernen
In PostgreSQL, MySQL, SQL Server, MongoDB, Supabase, BigQuery, Snowflake, Redshift, Databricks, S3, GCS oder Azure laden
Große Datensätze in Batches streamen, sodass Größe selten ein Problem ist
Inkrementelle Loads und geplante Aktualisierungen mit Airflow, GitHub Actions oder cron
Text-Datasets eingebettet und in pgvector, Pinecone oder Qdrant für KI und RAG geladen
Du erhältst:
- Abfragebereite Tabellen in deinem Speicher
- Sauberen, wiederverwendbaren Python-Code
- Eine README und einen Validierungsbericht (Zeilenzahl, Schema)
Ich prüfe jede Dataset-Lizenz und markiere Einschränkungen vor dem Laden.
Nicht sicher, welches Paket passt? Schick mir den Dataset-Link und dein Ziel vor der Bestellung, und ich empfehle dir eine Option.