Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Machine Learning Ingenieur, AI Agents, MCP und Computer Vision
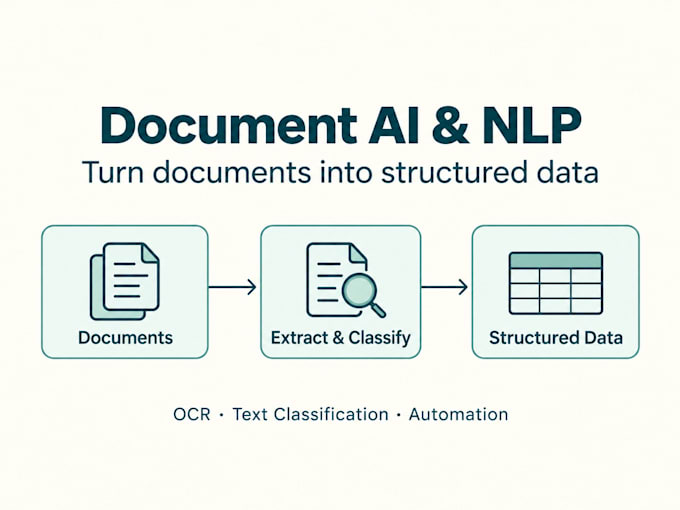
Ich entwickle NLP- und Dokumentenverarbeitungs-Pipelines für Textklassifikation, strukturierte Extraktion und Workflow-Automatisierung.
Je nach Aufgabe bereite ich Daten vor und label, fine-tune ein Transformer-Modell oder nutze eine LLM-Extraktionspipeline, validiere Felder und liefere Python-Code oder einen FastAPI-Service.
Mein Beschaffungsprozess umfasst die Klassifikation der Berechtigung mit Macro F1 0.9639 und 96,4 % Genauigkeit sowie Dokumentenextraktions-Pipelines, die etwa 2000 Mitteilungen pro Tag verarbeiten. Diese Ergebnisse stammen aus spezifischen Projekten und sind keine Garantie für neue Daten.
Der Umfang kann PDF-, HWP/HWPX- oder Textverarbeitung, JSON- oder CSV-Ausgaben, Feldvalidierung, Bewertung und Deployment-Anweisungen umfassen. OCR und ungewöhnliche Layouts sollten vor der Bestellung besprochen werden.
Bitte sende repräsentative Dateien, erforderliche Felder oder Labels, Datenvolumen und deine Zielumgebung. Wir einigen uns vor Beginn der Arbeit auf die Lieferungen und Akzeptanzkriterien.

Automatische Übersetzung
Welche relevante NLP-Erfahrung hast du?
Ich habe Klassifikatoren für die Berechtigungsprüfung im Beschaffungswesen mit RoBERTa und LoRA gebaut, Dokumentenextraktions-Pipelines entwickelt und INT8 ONNX-Modelle über FastAPI bereitgestellt. Meine Arbeit umfasst Datenvorbereitung, Evaluation und Deployment, wobei die Ergebnisse für jede Aufgabe separat gemessen werden.
Was, wenn ich nur sehr wenige gelabelte Daten habe?
Wir können Transfer Learning, Weak Supervision oder eine LLM-Baseline in Betracht ziehen, abhängig von der Aufgabe. Ich werde repräsentative Beispiele prüfen und auf gehaltenen Daten evaluieren. Ein kleines Sample allein garantiert keine zuverlässige Genauigkeit.
Kannst du auch Daten sammeln?
Datenvorbereitung oder -sammlung kann eingeschlossen werden, wenn Quellen, autorisierter Zugriff und erforderliche Felder im Voraus vereinbart werden. Dokumentenformate und OCR-Bedürfnisse müssen anhand von Beispiel-Dateien überprüft werden, bevor ich den Umfang bestätige.
Wie genau können die Modelle sein?
Die Genauigkeit hängt von der Aufgabe, den Labels, der Datenqualität und der Bewertungsaufteilung ab. Wir legen eine Basislinie fest und messen auf gehaltenen Beispielen mit geeigneten Metriken wie Präzision, Recall und F1. Ergebnisse aus früheren Projekten sind keine Garantien für einen neuen Datensatz.
