Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden



Automatische Übersetzung
Du suchst nach einem schnellen, zuverlässigen Web Scraper oder einer automatisierten Data-Extraction-Pipeline? Du bist hier genau richtig!
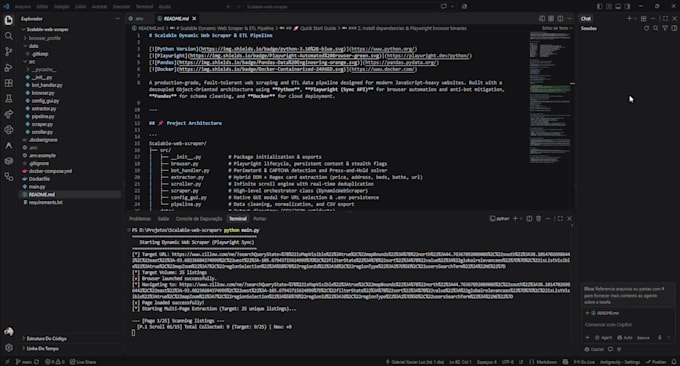
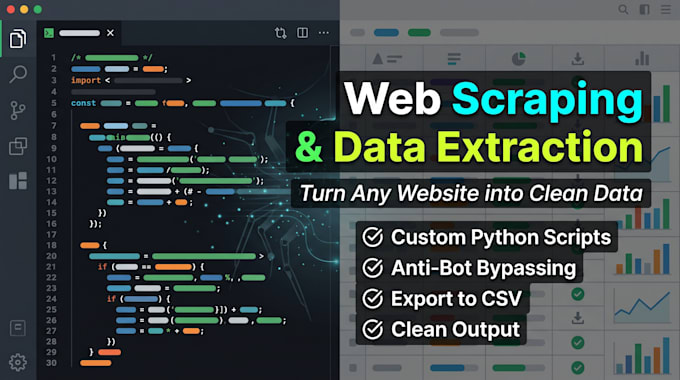
Ich baue produktionsreife Web Scraper in Python mit Playwright, Pandas und Docker. Im Gegensatz zu einfachen Skripten, die auf modernen Webseiten versagen, können meine Lösungen komplexe dynamische JavaScript-Anwendungen, unendliches Scrollen und Anti-Bot-Abwehrmaßnahmen handhaben.
Was ich liefere: Dynamiques JS Scraping: Einzelseiten-Anwendungen, endloses Scrollen und lazy geladene Elemente. Anti-Bot- & CAPTCHA-Umgehung: Umgeht PerimeterX, Cloudflare und Challenge-Overlays mit persistenten Cookies und menschlich simulierten Browser-Mechaniken. Automatisierte Datenbereinigung (Pandas): Normalisiert Rohtext zu sauberen Zahlen, teilt Adressen auf und entfernt Duplikate. Multi-Page Traversal: Automatisierte Paginierung zur Extraktion großer Datensätze. Saubere Formate: Excel-fertig CSV, JSON oder Google Sheets. Docker Ready: 1-Klick-Containerbereitstellung für lokale PCs oder Cloud-Server (AWS/GCP).
Anwendungsfälle: Immobilienangebote, Preisgestaltung im E-Commerce, B2B-Verzeichnisse.
️Bitte schreib mir vor einer Bestellung deine Ziel-URL und Anforderungen!
Python Developer, Automation and Data Processing
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Warum sollte ich Ihnen eine Nachricht senden, bevor Sie eine Bestellung aufgeben?
Jede Webseite hat ihre eigene Struktur, dynamisches JavaScript-Verhalten und Anti-Bot-Schutz. Die Überprüfung der Ziel-URL im Voraus ermöglicht es mir, Machbarkeit zu prüfen, die benötigten Datenfelder festzulegen und dir das kostengünstigste Paket anzubieten.
Kannst du Webseiten mit CAPTCHAs, Cloudflare oder PerimeterX scrapen?
Ja! Ich arbeite mit Playwright, bleibenden Browser-Sitzungen, menschlich simulierten Mausbewegungen und Stealth-Flag-Konfigurationen, die speziell dazu entwickelt wurden, moderne Bot-Verifikationsoverlays und dynamische Challenges zu umgehen.
In welchen Formaten erhalte ich die extrahierten Daten?
Ich liefere saubere, formatierte Daten in Excel-fertigem CSV (korrekt codiert, um Formatierungsfehler zu vermeiden), XLSX, JSON oder direkte Synchronisation zu Google Sheets. Du erhältst außerdem den vollständigen Python-Source-Code und die Dokumentation.
Was brauche ich, um diesen Scraper auf meinem eigenen Computer laufen zu lassen?
Du hast zwei einfache Optionen: Entweder lokal mit normalem Python laufen lassen oder das enthaltene Docker-Setup verwenden (docker compose up), um den gesamten Scraper in einem einzigen Befehl zu starten – ohne Installation von Abhängigkeiten!
Kann dieser Scraper automatisch in der Cloud zeitgesteuert laufen?
Ja! Mit der enthaltenen Docker-Datei ist der Scraper 100% cloud-ready und kann zu AWS, Google Cloud Run oder DigitalOcean deployed werden, um automatisch nach Cron-Jomen (z. B. täglich oder wöchentlich) zu laufen.