Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Musst du Daten zwischen Datenbanken, Dateien oder APIs verschieben, transformieren, bereinigen oder synchronisieren?
Ich erstelle eine zuverlässige ETL/ELT-Datenpipeline mit Python und SQL, um Daten zwischen verschiedenen Quellen und Ziel-Datenbanken zu bewegen.
Ich kann einfache Batch-Pipelines sowie strukturierte Datenintegrationslösungen bauen.
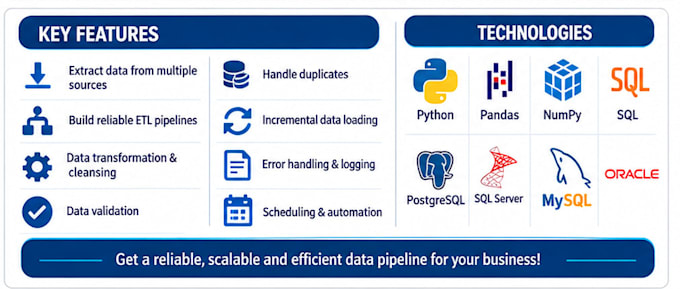
Ich kann Pipelines für folgende Systeme erstellen:
TECHNOLOGIEN
Automatische Übersetzung
F: Kannst du Daten zwischen PostgreSQL und SQL Server verschieben?
A: Ja. Ich kann Batch-basierte Pipelines zwischen PostgreSQL und SQL Server erstellen.
Q: Kannst du mit APIs arbeiten?
A: Ja. Ich kann Daten aus REST APIs extrahieren und in Datenbanken laden.
F: Können Sie mit großen Datenmengen umgehen?
A: Ja. Ich kann Batch-Verarbeitung, inkrementelles Laden und datenbankseitige Verarbeitung nutzen, um Speicher- und Datenbank-Overhead zu reduzieren.
F: Kannst du doppelte Daten bereinigen?
A: Ja. Ich kann Validierungs- und Dublettenerkennungsregeln basierend auf deinen Geschäftsanforderungen implementieren.
F: Kannst du die Pipeline planen?
A: Ja. Das Scheduling kann mit verfügbaren Tools wie cron oder anderen Orchestrierungsplattformen je nach deiner Umgebung umgesetzt werden.