Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Daten Analyst
Neue Verkäuferpreise: Die ersten 5 Aufträge sind rabattiert, während ich meine Bewertungs-Historie aufbaue.
Ein Modell, das du verteidigen kannst, nicht nur eine Punktzahl, der du vertrauen musst.
Was du bekommst
- Ehrliche Validierung: stratifizierte oder zeitbasierte Aufteilung, so wie sie ist
- Feature Engineering, das auf dein Business abgestimmt ist: RFM, Verhaltens-, Transaktions- und zeitbasiert
- Modelle auf derselben Aufteilung verglichen, damit die Entscheidung gerechtfertigt ist, nicht nur angenommen
- Klassenungleichgewicht richtig behandelt: SMOTE, Klassen-Gewichte oder Schwellenwertanpassung
- Wichtigkeit der Features bewertet und in Business-Begriffe übersetzt
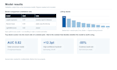
- Eine Zusammenfassung, die auch ein nicht-technischer Stakeholder lesen kann: AUC, Lift, Präzision bei K
Tools: Python (Pandas, scikit-learn, NumPy, LightGBM), SQL
Erfolgsgeschichte: Churn- und Recall-Modelle bei AUC 0.80, Vorhersage der Bestellkonversion über 47 Features bei AUC 0.82, und ein Lead-Scoring-Modell, das die High-Confidence-Handover-Rate von 7,7 % auf 20 % erhöht hat.
Was ich brauche: eine Zielspalte, einige Tausend Zeilen Historie und die Entscheidung, die die Punktzahl beeinflussen soll. Wenn deine Daten noch unordentlich sind, reinige ich sie entweder im Premium-Tarif oder du bestellst zuerst mein Data Cleaning Gig.
Schreib mir mit deiner Zeilenzahl und Zielspalte, und ich bestätige den Umfang, bevor du bestellst.
Programmiersprache:
Python
•
SQL
Frameworks:
scikit-learn
•
Panda
Tools:
Jupyter-Notizbuch
•
Excel
Automatische Übersetzung
Welchen Algorithmus wirst du verwenden?
Je nach Problem, nicht aus Gewohnheit: reguläre lineare Modelle als Basis, Baum-Ensembles (LightGBM, scikit-learn), SVM oder k-NN für kleine nicht-lineare Daten, Clustering für Segmente, Ranking für geordnete Listen. Basierend auf Validierung, niemals nach Mode – und ich sage dir, was ich abgelehnt habe.
Welche Genauigkeit kann ich erwarten?
Ich verspreche keine Zahl, bevor ich die Daten gesehen habe, und wer das tut, rät nur. Was ich zusichere, ist ehrliche Validierung und ein klares Bericht darüber, wo das Modell versagt. Zur Orientierung: Meine eigenen Projekte erreichten bei Churn- und Konversionsproblemen eine AUC von 0.80 bis 0.82.
Mein Datensatz ist klein oder unausgewogen. Kannst du trotzdem damit arbeiten?
In der Regel ja. Ungleichgewicht wird mit SMOTE, Klassen-Gewichten oder Schwellenwertanpassung behandelt, nicht ignoriert. Kleine Daten sind allerdings eine echte Grenze – wenn es zu wenige positive Fälle gibt, sage ich dir das offen, bevor du bestellst, anstatt ein Modell zu liefern, dem du nicht vertrauen kannst.
Bekomme ich den Code?
Ja bei jedem Paket. Du bekommst ein Notebook oder Script, das du erneut ausführen kannst, plus die finale Feature-Liste. Das Premium-Paket enthält ein Produktionsscript, Dokumentation und ein Übergabegespräch.
Kannst du das Modell für mich in Produktion bringen?
Ich mache keine Cloud-Deployments oder API-Integrationen. Ich sage dir das lieber vorher, als den Auftrag anzunehmen und dich zu enttäuschen. Was du bekommst, ist ein Modell und ein Script, das dein Engineering-Team direkt deployen kann.
Meine Daten sind sensibel. Wie gehst du damit um?
Schick mir eine maskierte Extract oder eine kleine Probe, wenn du möchtest. Ich brauche nur die Spalten, die das Modell wirklich braucht. Ich teile deine Dateien nicht mit anderen und lösche die Arbeitskopie, sobald der Auftrag abgeschlossen ist.


