Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
KI-Dateningenieur, RAG-Pipelines, PDF zu Markdown, lokale LLMs
Schütze deine proprietären Firmendaten mit einer 100% privaten, lokal feinabgestimmten KI.
Das Senden sensibler Geschäftsdokumente, Schulungsmaterialien oder interner Kenntnisse an öffentliche Cloud-APIs ist ein erhebliches Sicherheitsrisiko und verstößt häufig gegen GDPR-Vorschriften.
Ich entwickle sichere, offline laufende KI-Modelle, die speziell auf deine Branche zugeschnitten sind. Durch die Nutzung hochentwickelter Apple Silicon Architektur (128 GB Unified Memory) und fortschrittlicher Frameworks wie MLX und Unsloth verlässt deine Daten während des Trainingsprozesses niemals meine isolierte, lokale Hardware.
Was ich liefere:
Mein Tech-Stack & Expertise:
Bitte schreibe mir, bevor du eine Bestellung aufgibst.


Programmiersprache:
Python
Datentyp:
Text
KI-Engine:
Andere
Automatische Übersetzung
Warum sollte ich lokal feinabstimmen, anstatt OpenAI oder andere Cloud-APIs zu nutzen?
Cloud-APIs stellen ein erhebliches Sicherheitsrisiko für proprietäre Firmendaten dar und verletzen häufig strenge GDPR-Richtlinien. Lokale Feinabstimmung garantiert, dass deine sensiblen Dokumente, Kundendaten und internen Kenntnisse niemals eine isolierte, offline Umgebung verlassen. Du behältst 100% der Datenhoheit.
Kannst du größere Modelle auf lokaler Hardware feinabstimmen?
Ja. Ich nutze eine hochentwickelte Apple Silicon Architektur mit 128 GB Unified Memory. Zusammen mit fortschrittlichen Quantisierungsframeworks wie MLX und Unsloth (QLoRA) ermöglicht mir dieses enorme Speicherbandbreite, große Open-Source-Modelle wie Llama, Mistral oder Qwen effizient feinabzustimmen und auszuführen.
In welchem Format sollten meine Trainingsdaten vorliegen?
Für das Standard-Paket solltest du deine Daten als saubere JSONL-Datei mit strukturierten Anweisungs-Antwort-Paaren vorbereiten. Wenn dein Wissen derzeit in unordentlichen PDFs, Rohtexten oder internen Dokumenten steckt, beinhaltet mein Premium-Paket eine individuelle Python-Vorverarbeitung, um Daten zu extrahieren, zu bereinigen und zu formatieren.
Welche genauen Dateien erhalte ich bei der Lieferung?
Du erhältst die feinabgestimmten LoRA-Adaptergewichte zusammen mit einer vollständig zusammengeführten und quantisierten Modell-Datei (GGUF-Format). Diese GGUF-Datei ist einsatzbereit und kann sofort in lokale Inferenz-Engines wie Ollama, LM Studio oder AnythingLLM auf deiner eigenen Firmenhardware gezogen und abgelegt werden.
Wie stellst du sicher, dass das Modell tatsächlich mein Fachgebiet lernt und nicht nur überfit?
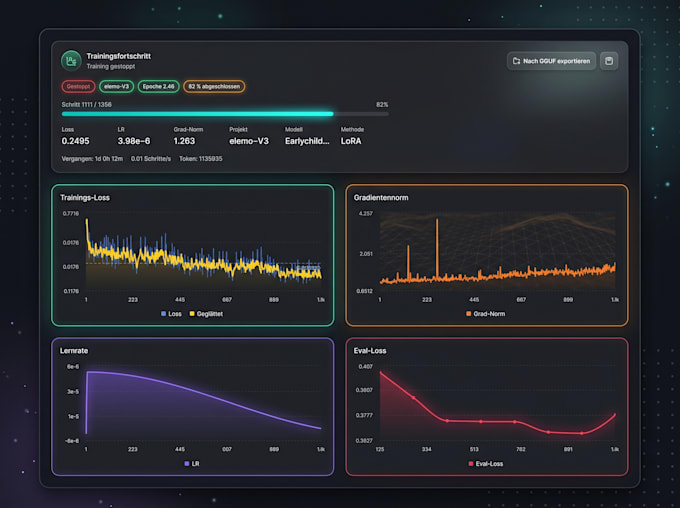
Ich überwache sorgfältig die Verlustkurven während des Trainings und passe die Hyperparameter an, um sicherzustellen, dass das Modell gut auf deine spezifische Terminologie generalisiert.