Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
KI-Dateningenieur, RAG-Pipelines, PDF zu Markdown, lokale LLMs
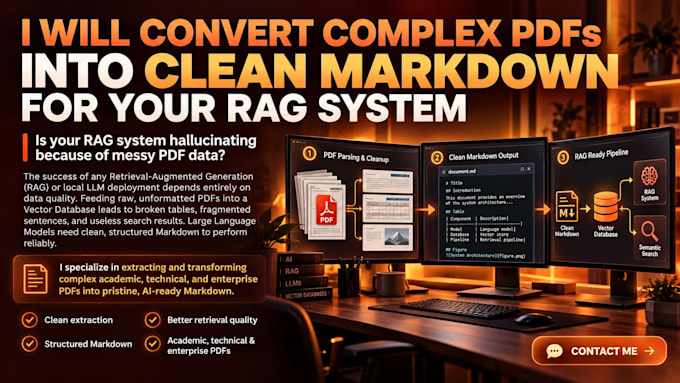
Stürzt dein RAG-System ab, weil die PDF-Daten unordentlich sind?
Der Erfolg jeder RAG- oder lokalen LLM-Implementierung hängt vollständig von der Datenqualität ab. Roh-PDFs in eine Vektor-Datenbank zu laden, führt zu zerbrochenen Tabellen und nutzlosen Suchergebnissen. LLMs brauchen sauberes, strukturiertes Markdown, um zuverlässig zu funktionieren.
Ich spezialisiere mich darauf, komplexe akademische, technische und unternehmensbezogene PDFs in makelloses, KI-bereites Markdown zu verwandeln.
Was ich liefere:
Das Datenschutz-First-Garantie: Als Unternehmens-KI-Architekt verarbeite ich hochsensible Daten lokal auf leistungsstarker Edge-Hardware. Deine vertraulichen Handbücher und Berichte werden NIEMALS an Cloud-APIs gesendet. 100% offline, 100% GDPR-konform.
Hör auf, Entwicklerstunden für manuelle Formatierung zu verschwenden. Ich liefere die saubere Datenbasis, die deine KI braucht.
Bitte kontaktiere mich vor der Bestellung, um deine Dokumente zu besprechen.

Automatische Übersetzung
Werden meine vertraulichen Dokumente in die Cloud gesendet?
Absolut nicht. Ich garantiere eine strikte "Zero-Cloud"-Politik. Alle PDFs werden 100% lokal auf meiner offline Edge-Hardware verarbeitet. Es werden keine OpenAI- oder Drittanbieter-APIs verwendet, was totale Datenhoheit und strikte GDPR-Konformität gewährleistet.
Kannst du Daten Tabellen und Codeblöcke korrekt extrahieren?
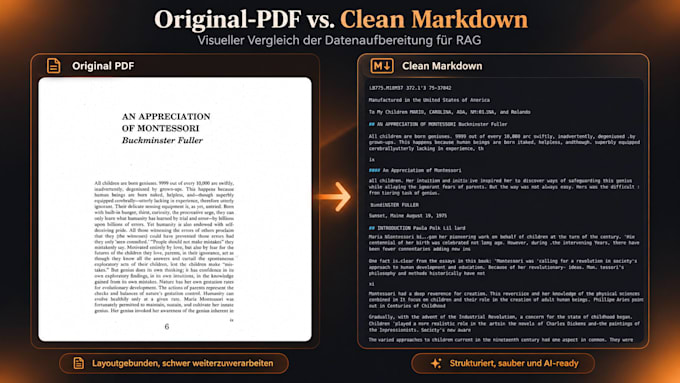
Ja. Im Gegensatz zu einfachen Extraktionstools parst mein Pipeline Daten Tabellen und Code-Snippets präzise und wandelt sie nativ in sauberes, strukturiertes Markdown um, das deine Vektor-Datenbank und LLMs perfekt verstehen können.
Was, wenn mein PDF ein komplexes Mehrspalten-Layout hat?
Mehrspalten-Layouts werden reibungslos verarbeitet. Die Pipeline nutzt fortschrittliche Layout-Erkennung, um sicherzustellen, dass der Text in der richtigen, logischen Lesereihenfolge fließt und so die üblichen Brüche und Zeilenumbrüche bei Standard-PDF-Konvertern vermieden werden.
Welche Dokumentensprachen verarbeitest du?
Ich spezialisiere mich auf die Verarbeitung und manuelle Qualitätskontrolle von Dokumenten in Englisch und Deutsch. Die Beschränkung des Services auf diese Sprachen ermöglicht es mir, die strukturelle Integrität und Formatierung des finalen Markdown-Outputs vor der Lieferung persönlich zu überprüfen.
Ich habe Tausende von Seiten. Kannst du riesige Unternehmensarchive bewältigen?
Ja. Das 500-Seiten-Premium-Paket ist nur ein Ausgangspunkt. Für riesige Unternehmensarchive oder hochspezifische OCR-Anforderungen (gescannte Dokumente) kontaktiere mich direkt. Ich entwickle eine maßgeschneiderte, automatisierte ETL-Pipeline speziell für deinen Dokumentenkorpus.