Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD


Automatische Übersetzung
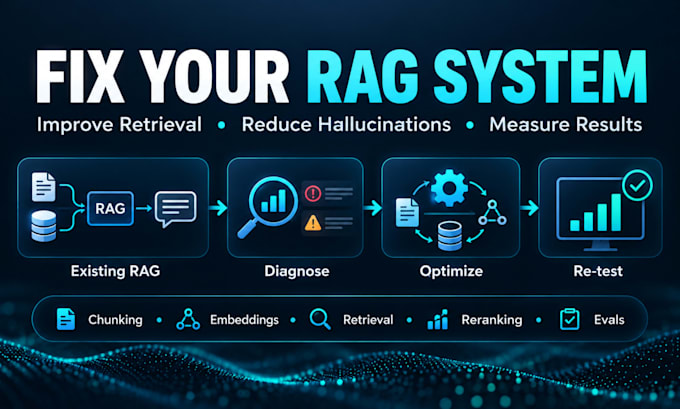
Liefert dein RAG-System die falschen Dokumente, halluziniert, produziert unzuverlässige Zitate oder ist zu langsam?
Ich diagnostiziere und optimiere deine bestehende RAG-Pipeline mit messbaren Vorher/Nachher-Tests, nicht durch zufällige Prompt-Änderungen.
Ich kann helfen, folgendes zu verbessern:
- Chunking-Strategie
- Embeddings und Vektor-Suche
- Retrieval-Genauigkeit
- Metadaten-Filterung
- Hybride Suche
- Reranking
- Prompt- und Kontextaufbau
- Halluzinationen reduzieren und verankern
- Zitationsqualität
- Latenz und Token-Nutzung
- Leistung der Vektor-Datenbank
- RAG-Bewertung
Mein Prozess:
Messung -> Diagnose -> Behebung -> Neuer Test -> Vergleich
Ich arbeite mit Python-basierten RAG-Systemen, LangChain, LlamaIndex, FastAPI, OpenAI, Claude, lokalen LLMs, Pinecone, Qdrant, Chroma, Weaviate, pgvector und ähnlichen Stacks.
Du erhältst klare Nachweise über:
- Was das Problem verursacht hat
- Was geändert wurde
- Wie das System vor und nach der Änderung performt hat
- Etwaige verbleibende Einschränkungen
Dieses Gig ist für bestehende RAG-Systeme. Für große Produktionssysteme, mehrere Integrationen oder Architektur-Rebuilds kontaktiere mich bitte vor der Bestellung.
AI and Data Science Engineer, RAG, MCP and LLM Automation
Sprachen
Automatische Übersetzung
Automatische Übersetzung
1. Baust du ein neues RAG-System von Grund auf auf?
Dieses Gig konzentriert sich auf die Diagnose und Verbesserung einer bestehenden RAG-Pipeline. Die Entwicklung eines neuen Systems sollte als individuelles Projekt erfolgen.
2. Kannst du Halluzinationen reduzieren?
Ja. Ich untersuche, ob Halluzinationen durch Retrieval, Chunking, Kontextaufbau, Prompting, Zitate oder Modellverhalten entstehen, und behebe die eigentliche Ursache.
3. Kannst du die Retrieval-Genauigkeit verbessern?
Ja. Ich kann Chunking, Embeddings, Vectorsuche, Metadaten-Filter, Hybridsuche, Reranking und Retrieval-Einstellungen überprüfen.
4. Kannst du mit Pinecone, Qdrant, Chroma, Weaviate oder pgvector arbeiten?
Ja, abhängig von deiner aktuellen Architektur und den Projektanforderungen.
5. Kannst du Latenz und API-Kosten optimieren?
Ja. Latenz, Token-Nutzung, Kontextgröße, unnötige LLM-Aufrufe und Retrieval-Effizienz können überprüft und optimiert werden.
6. Kannst du eine bestimmte Genauigkeitssteigerung garantieren?
Nein. Ich messe zuerst die aktuelle Basislinie und berichte dann die tatsächliche Verbesserung anhand repräsentativer Testfälle.
7. Was brauchen Sie von mir, um zu beginnen?
Bitte gib deinen Quellcode oder dein Repository, die aktuelle RAG-Architektur, die Vektor-Datenbank, das Embedding-Modell, Beispiel-Dokumente aus der Wissensdatenbank, repräsentative Testfragen und einige Beispiele für die Fehler, die du beheben möchtest. Falls du erwartete Antworten, Logs oder Bewertungsergebnisse hast, sind diese ebenfalls hilfreich