Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD


Automatische Übersetzung
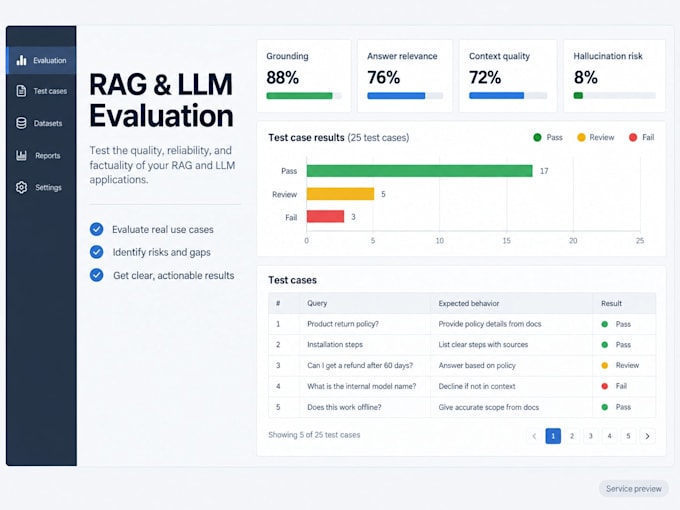
Erzeugt deine RAG- oder LLM-Anwendung unsupported, irrelevante oder inkonsistente Antworten? Ich werde ihr Verhalten bewerten und evidenzbasierte Empfehlungen zur Verbesserung geben.
Ich kann beurteilen:
Antwortrelevanz, Klarheit und Vollständigkeit
Verankerung im abgerufenen Kontext
Halluzinationen und unsupported claims
Qualität der Abfrage und Nützlichkeit der Quellen
Zitationskonsistenz
Fehlermuster und Fallback-Verhalten
Latenz- und Kostenindikatoren bei verfügbaren Daten
Entscheidungen zu Chunking, Kontext und Modellkonfiguration
Je nach Paket werde ich bereitgestellte Testfälle überprüfen, eine strukturierte Bewertungsmenge erstellen, Retrieval- und Generierungsfehler analysieren und automatisierte Metriken verwenden, wenn sie technisch sinnvoll sind. Du erhältst einen klaren Bericht, der Beobachtungen, Beweise, Einschränkungen und priorisierte Empfehlungen trennt.
Bitte stelle Zugang zu einer sicheren Testumgebung oder exportierten Anwendungsergebnissen, abgerufenen Kontexten, erwarteten Antworten (falls vorhanden) und einer Beschreibung der vorgesehenen Nutzer und Anwendungsfälle bereit. Entferne API-Schlüssel, Produktionsanmeldedaten und private Kundendaten.
Dieses Gig bewertet ein bestehendes System. Die Umsetzung größerer Änderungen, der Neuaufbau der RAG-Pipeline, die Produktionseinführung und
Python Backend Applied AI Developer
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Q: Was zählt als ein Bewertungfall?
A: Ein Fall umfasst eine Nutzerfrage, die generierte Antwort und den abgerufenen Kontext oder Quellen, die zur Erstellung verwendet wurden. Erwartete oder Referenzantworten sind hilfreich, aber nicht immer erforderlich.
Q: Brauche ich Zugriff auf mein Produktionssystem?
A: Nein. Ich bevorzuge eine sichere Testumgebung, exportierte Ergebnisse oder eine reproduzierbare lokale Version. Bitte entferne API-Schlüssel, Produktionsanmeldedaten, persönliche Informationen und vertrauliche Kundendaten, bevor du etwas teilst.
Q: Welche Bewertungsmetriken verwendest du?
A: Die Metriken hängen von der Anwendung und den verfügbaren Daten ab. Die Bewertung kann die Antwortrelevanz, Kontextrelevanz, Treue, Quellenverankerung, Retrieval-Qualität, Halluzinationsmuster, Latenz und Kostenindikatoren umfassen. Automatisierte Werkzeuge wie RAGAS oder gleichwertige Methoden können bei Bedarf eingesetzt werden.
Q: Wirst du die empfohlenen Verbesserungen umsetzen?
A: Dieses Gig konzentriert sich auf Bewertung und Empfehlungen. Kleine vereinbarte Anpassungen können separat angeboten werden, während größere Pipeline-Änderungen, neue Funktionen und Deployment ein individuelles Angebot erfordern.
Q: Kannst du garantieren, dass die Bewertung Halluzinationen eliminiert?
A: Kein verantwortungsvoller Bewerter kann garantieren, dass ein LLM niemals halluziniert. Ich werde beobachtete Fehlermuster identifizieren, sie wo möglich messen und praktische Wege empfehlen, ihre Häufigkeit und Auswirkungen zu verringern.