Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Bachelor in Data Science und Künstliche Intelligenz
Datenbereinigung und Vorverarbeitung
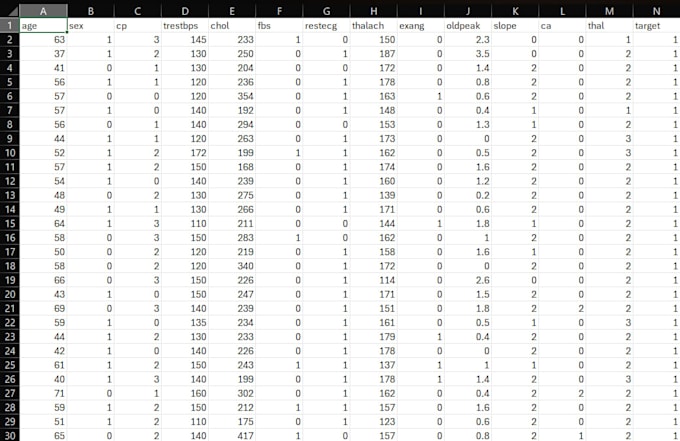
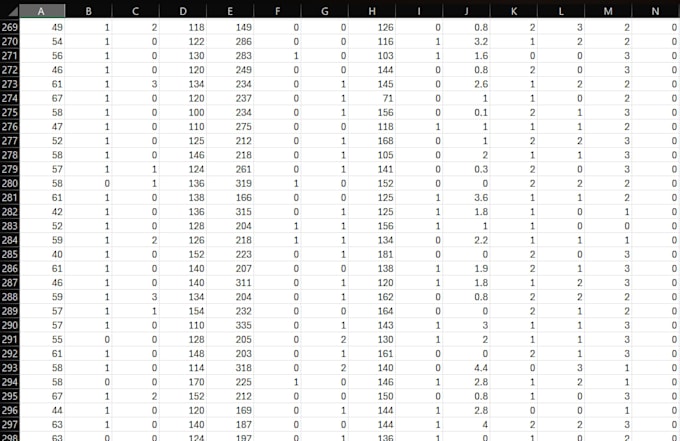
Datenbereinigung ist ein wesentlicher Schritt im Datenanalyse- und Data-Science-Prozess. Dabei werden ungenaue, unvollständige, inkonsistente oder doppelte Daten identifiziert, korrigiert und behandelt, um die Gesamtqualität und Zuverlässigkeit eines Datensatzes zu verbessern.
Die Arbeit umfasst das Verstehen des Datensatzes, das Erkunden seiner Struktur, das Identifizieren fehlender Werte, das Entfernen doppelter Datensätze, das Umgang mit Ausreißern, das Korrigieren inkonsistenter Datenformate, das Beheben falscher Datentypen und das Standardisieren von Werten.
Außerdem geht es darum, Rohdaten in ein strukturiertes und sinnvolles Format zu transformieren, damit sie effektiv für weitere Analysen, Visualisierungen und Anwendungen des maschinellen Lernens genutzt werden können.
Wichtige Aktivitäten:
- Verstehen und Erkunden roher Datensätze.
- Identifizieren und Umgang mit fehlenden oder Nullwerten.
- Entfernen von Duplikaten und unnötigen Datensätzen.
- Erkennen und Verarbeiten von Ausreißern.
- Korrigieren inkonsistenter Einträge und Formatierungsfehler.
- Umwandeln von Spalten in passende Datentypen.
- Standardisieren und Transformieren von Daten.
- Validieren des bereinigten Datensatzes auf Genauigkeit und Konsistenz.
- Aufbereiten von Datensätzen für explorative Datenanalyse (EDA) und maschinelles Lernen.