Kategorien durchsuchen
Deutsch
$
USD
Verbinden Sie sich mit Ihrer KI




Automatische Übersetzung
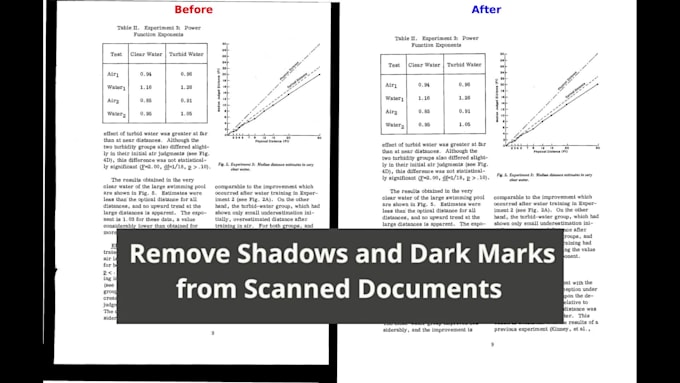
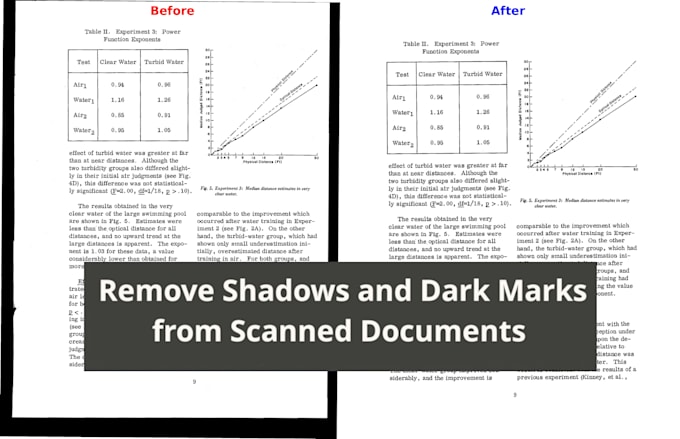
Hast du gescannte PDFs oder Dokumente mit dunklen Schatten, grauen Flächen oder schmutzigen Rändern? Sie sind schwer lesbar und verschwenden Tinte/Toner beim Drucken?
Ich spezialisiere mich auf die Reinigung gescannter Dokumente mit Python und Linux-Tools – keine manuelle Photoshop-Retusche. Das sorgt für konsistente, präzise Ergebnisse, selbst bei großen Multi-Page-PDFs.
Ich bin ein computationaler Sozialwissenschaftler und habe Tausende von Scans verarbeitet, indem ich Skripte erstellt habe, die typische Scan-Artefakte automatisch entfernen.
Was ich mache:
Warum das besser ist als manuelle Bearbeitung:
Ideal für Studenten, Forscher, Archivare und alle, die gescannte Bücher, Artikel oder Berichte haben. Dieses Gig konzentriert sich auf Textdokumente, nicht auf allgemeine Fotoretusche.
Bitte informiere den Freelancer über alle Präferenzen oder Bedenken in Bezug auf den Einsatz von KI-Tools bei der Ausführung und/oder Lieferung deines Auftrags.
algorithmic scan cleaning,document post processing, image processing
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Warum ist algorithmische Verarbeitung besser als Photoshop?
Die algorithmische Verarbeitung erfolgt automatisch mit Python- und Linux-Tools. Alle Seiten werden nach den gleichen Regeln gereinigt – ohne manuelle Bearbeitung oder menschliche Fehler. Das sorgt für gleichbleibende Qualität und spart erheblich Zeit.
Wird das Endergebnis so sauber aussehen wie eine Buchseite?
Die Qualität hängt vom Originalscan ab. Sehr schlechte Kopien (zum Beispiel Kopien von bereits schlechten Kopien) lassen sich möglicherweise nicht vollständig verbessern. In den meisten Fällen wird das Ergebnis jedoch deutlich sauberer, klarer und angenehmer zu lesen.
Kann ich Scans schicken, bei denen ein Bild mehrere Seiten enthält?
Ja, du kannst Scans schicken, die eine oder zwei Seiten enthalten (eine typische Buchseite). Wenn ein einzelnes Bild mehr als zwei Seiten oder sehr kleine Miniaturseiten enthält, wird die Reinigung weniger genau sein. Bitte vermeide es, viele Seiten in einem Bild zu kombinieren.
Was, wenn ich mehr als 50 Seiten reinigen lassen möchte?
Wenn du mehr als etwa 50 Seiten hast, kontaktiere mich bitte, um eine individuelle Bestellung zu besprechen.
Was bedeutet eine Überarbeitung der Bestellung?
Eine Überarbeitung bedeutet, kleine Anpassungen vorzunehmen (z.B. stärkere Reinigung, Dateiformat ändern oder Seitenreihenfolge anpassen). Es bedeutet nicht, das gesamte Dokument neu zu verarbeiten.
Warum ist die gereinigte Datei größer als die Originaldatei?
Nach der Verarbeitung können die Dateien größer werden, weil die Bildqualität und Klarheit verbessert werden. Ich versuche stets, ein gutes Gleichgewicht zwischen Dateigröße und Textlesbarkeit zu halten.
Kann ich eine superschnelle Lieferung bekommen?
Die in den Stufen genannten Lieferzeiten geben die maximale Dauer an, die für die Reinigung und Lieferung deiner Scans benötigt wird. Wenn deine Scans jedoch nicht stark beschädigt sind, werden die meisten Aufträge in der Regel vor Ablauf der maximalen Zeit fertiggestellt.
Kann ich mehrere Basic-Pakete kaufen, um mehr Seiten zu reinigen?
Ja, du kannst das Basic-Paket für größere Dokumente vervielfachen. Allerdings wird nur Basic-Processing auf alle Seiten angewendet. Zusätzliche Services aus höheren Paketen (Standard oder Premium) werden nicht umgesetzt. Für fortgeschrittene Optionen kontaktiere mich bitte für ein individuelles Angebot.
Entfernt man Wasserzeichen?
Ich entferne oder ändere keine Wasserzeichen und verfälsche keine offiziellen/rechtlichen Dokumente.
Kannst du pro Seite berechnen?
Nein. Die Preise richten sich nach Bearbeitungszeit und Batch-Einrichtung, nicht nach einzelnen Seiten.