Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Leitender Dateningenieur
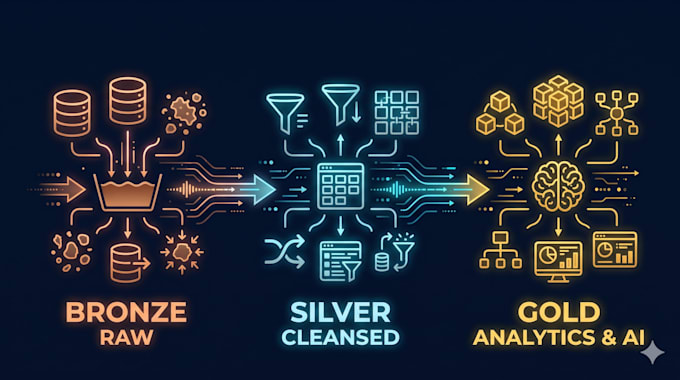
Hast du mit langsamen SQL-Abfragen, unübersichtlichen Daten-Silos oder hohen Cloud-Kosten zu kämpfen? Ich bin Enterprise Data Engineer (Microsoft Azure-zertifiziert) und spezialisiere mich auf PySpark, Azure Databricks, Delta Lake und SQL. Ich entwerfe, optimiere und baue fehlertolerante Datenarchitekturen, die Rohdaten in analytics-ready und AI-ready Pipelines verwandeln.
Was ich für dich tun kann:
Warum mit mir arbeiten?
Schreib mir vor der Bestellung, damit wir deinen Data-Stack und Scope abstimmen können!
Automatische Übersetzung
Kannst du neben der Architektur auch den eigentlichen PySpark-/SQL-Code schreiben?
Ja! Neben Audit und Architektur-Blueprints erstelle ich produktionsreife PySpark-Skripte, Databricks-Notebooks und optimierte SQL-Abfragen. Schreibe mir deine Anforderungen für ein individuelles Implementierungsangebot.