Kategorien durchsuchen
Deutsch
$
USD
Verbinden Sie sich mit Ihrer KI

Automatische Übersetzung
Deine LLM-Funktion hat das Demo bestanden. Gilt sie auch nach dem nächsten Prompt oder einer Änderung am Modell?
Ich erstelle Bewertungssuiten, die diese Frage beantworten. Du bekommst eine Rubrik, die auf deinen Anwendungsfall zugeschnitten ist, einen Testsatz mit erwarteten Antworten und, falls ein LLM deine Ausgaben bewertet, eine Prüfung, wie zuverlässig dieser Judge ist.
Was du bekommst:
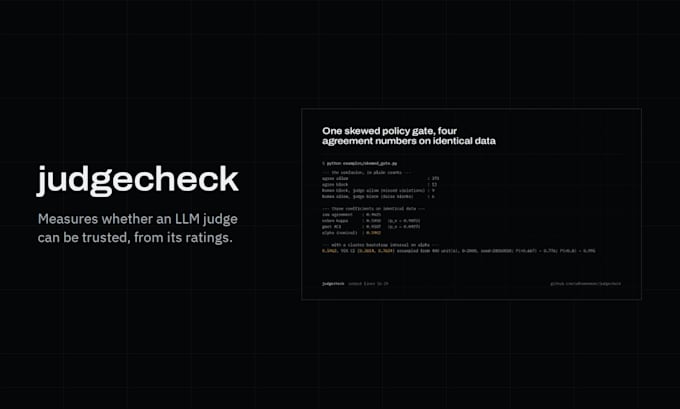
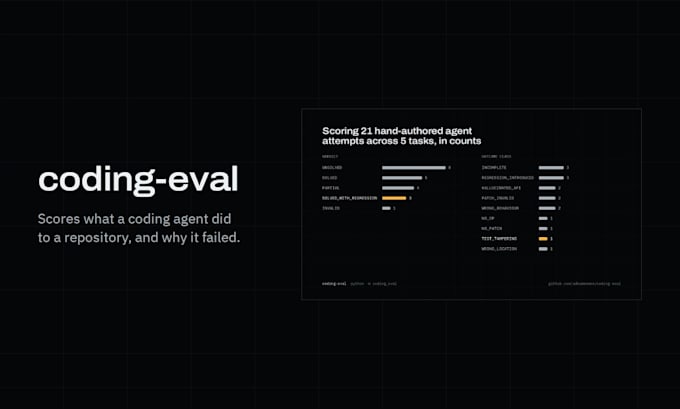
Warum ich: Ich habe judgecheck entwickelt, einen Zuverlässigkeitsbericht für LLM-Jurys, der zeigt, wie 96% rohe Übereinstimmung Zufalls-korrigierte Scores von bis zu 0,60 verbergen kann, und coding-eval, das Codierungsversuche in einer Sandbox nachstellt (20 von 21 behaupteten Erfolgen; 5 gelang). Ich bewerte Frontier-Modell-Code professionell und baue Rubrik- und Kalibrierungstools für arabische klinische KI.
Schreib mir eine Nachricht, beschreibe, was die Funktion tut, gib ein paar echte Eingaben und Ausgaben und sag mir, wie eine gute Antwort für dich aussieht.
AI Red Teaming and LLM Evaluation Engineer
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Was brauchst du von mir?
Zugang zum Modell oder zur API, die du verwendest (oder eine Datei mit gespeicherten Outputs), einige echte Beispiel-Eingaben und alle menschlichen Bewertungen, die du bereits hast. Falls du keine hast, vereinbaren wir gemeinsam eine kleine Bewertungsrunde.