Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Hervorragender Data Architect
Verschwende keine Zeit und kein Geld mehr an langsame SQL-Abfragen, defekte ETL-Pipelines und unausgereifte Datenarchitekturen.
Mit mehr als 15 Jahren Enterprise-Erfahrung in Data Engineering, Data Science und Big Data Architecture helfe ich Unternehmen, chaotische, unzuverlässige Daten in saubere, leistungsstarke Systeme zu verwandeln, die produktionsreif sind.
So kann ich dir helfen:
Warum mit mir arbeiten?
Bitte schreibe mir vor einer Bestellung mit einer kurzen Zusammenfassung deines aktuellen Data Stacks
Automatische Übersetzung
Muss ich sensible Produktionsdaten oder Datenbank-Zugangsdaten teilen?
Nein. Teile niemals Produktionspasswörter oder vertrauliche PII. Eine anonymisierte Datenauswahl, Schema DDL, Abfrageausführungsplan oder Architekturoberfläche reicht aus, um deine Lösung sicher zu diagnostizieren und zu entwerfen.
Was passiert, wenn mein Projekt mehr Arbeiten erfordert, als in den Paketen enthalten ist?
Jedes Paket deckt einen klar definierten Beratungs-, Audit- oder Architekturumfang ab. Wenn dein System eine größere individuelle Implementierung benötigt, schicke mir zuerst eine Nachricht und ich erstelle dir ein maßgeschneidertes Angebot.
Mit welchen Datenbanken, Sprachen und Cloud-Plattformen arbeitest du?
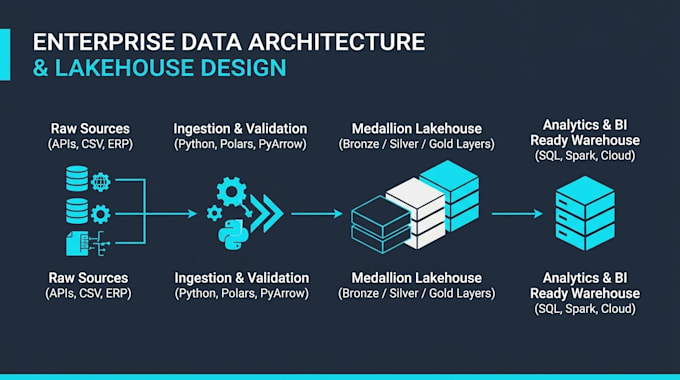
Ich arbeite mit modernen Data-Stapeln, darunter Python (Polars, PyArrow, Pandas), Apache Spark, SQL (PostgreSQL, SQL Server, MySQL, Snowflake, Redshift), AWS Data Services, SAP Data Integrations und Lakehouse-Architekturen.
Bietest du laufende Wartung oder Folge-Sitzungen nach der Lieferung an?
Liefergegenstände enthalten vollständige Dokumentation, damit dein Team alles eigenständig betreiben kann. Wenn du zusätzliche Review-Calls oder laufende Beratung wünschst, kannst du weitere Beratungsminuten hinzubuchen oder jederzeit eine Nachfolgesitzung buchen.