Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Hervorragender KI- und Maschinelles Lernen-Ingenieur
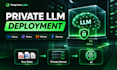
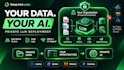
Ich stelle Open-Source-LLMs privat bereit, in deinem eigenen Cloud-Konto oder auf deinen eigenen Servern. Nichts wird an Drittanbieter-APIs gesendet.
Ich betreibe diesen Stack selbst: ein 32B Qwen-Modell, bereitgestellt mit vLLM, hinter einer OpenAI-kompatiblen API, mit API-Schlüsseln, Überwachungsdashboards (Prometheus und Grafana) und allem in einem Docker-Image verpackt.
Was du bekommst:
Optional: ein RAG-Chatbot, der aus deinen eigenen Dokumenten beantwortet und seine Quellen anzeigt.
Geeignet für Unternehmen, die private oder regulierte Daten verarbeiten (Kliniken, Recht, interne Dokumente).
Schreibe mir zuerst mit deiner GPU oder Cloud und dem Modell, das du im Sinn hast, und ich bestätige die passende Einrichtung.
Frameworks:
scikit-learn
•
DeepPy
•
Google ML Kit
•
PyTorch
Datentyp:
Code
Programmiersprache:
Python
•
R
•
SQL
•
Amazon SageMaker
Tools:
Jupyter-Notizbuch
•
tensorflow
•
Amazon SageMaker
•
Colab
Automatische Übersetzung
Brauche ich mein eigenes GPU- oder Cloud-Konto?
Beides funktioniert. Ich kann auf deinem eigenen Server oder in einem Cloud-Konto, das du besitzt (AWS, RunPod und ähnliche). Schreib mir zuerst, und ich berate dich zur GPU-Größe deines Modells.
Wiegt meine Daten meine Server verlassen?
Nein. Das Modell läuft in deiner Umgebung und nichts wird an Drittanbieter-APIs gesendet. Für die Einrichtung benötige ich lediglich Zugriff, den du danach wieder entziehen kannst.
Welche Modelle kannst du bereitstellen?
Open-Source-Modelle wie Qwen, Llama und Gemma, mit Quantisierung. Die beste Wahl hängt von deinem GPU-Speicher und deinem Anwendungsfall ab.
Kann der Assistent aus meinen eigenen Dokumenten antworten?
Ja, das ist das optionale RAG-Add-on. Es beantwortet aus deinen Dateien und zeigt die Quelle. Nenne mir die Dokumenttypen und das Volumen, bevor du bestellst.
Was brauchst du von mir, um anzufangen?
Deine GPU- oder Cloud-Daten, das Modell, das du im Sinn hast (falls vorhanden) und welche Apps es aufrufen werden. Ich bestätige die Einrichtung, bevor wir beginnen.


