Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Senior DevOps- und Netzwerksicherheitsingenieur sowie Linux-Experte
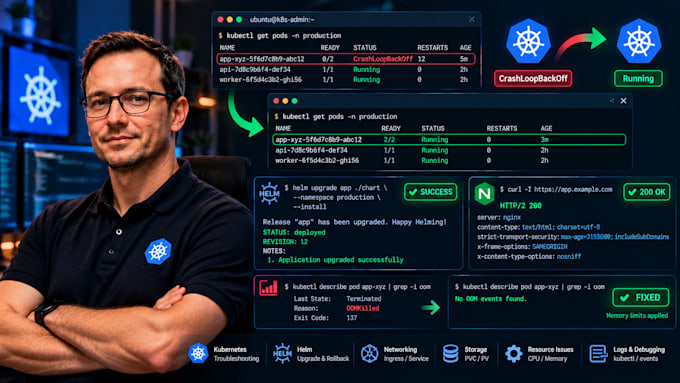
Kubernetes SOS Pods stürzen ab? Helm scheitert? Netzwerk ist defekt? Ich behebe es schnell.
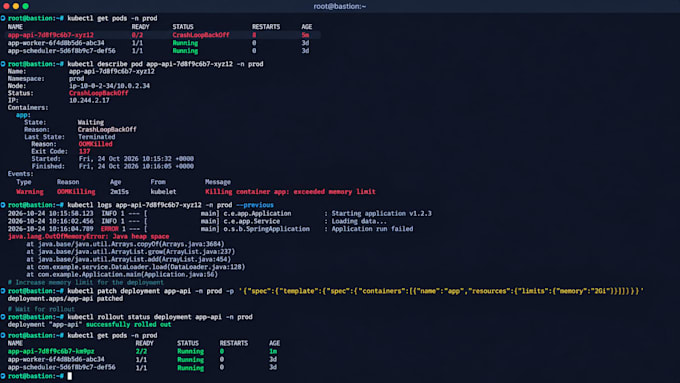
Ich bin Platform/DevOps Engineer mit über 5 Jahren Produktionserfahrung in K8s (EKS, GKE, AKS, Bare-M Metal). Ich runde mich nicht auf Vermutungen ab, sondern verwende einen bewährten **Debug-Playbook** (kubectl events logs metrics config), um die Ursache in Minuten zu finden.
WAS ICH BEHEBE (Jedes Paket):
CrashLoopBackOff / OOMKilled (137) Speicherkontingente, Lecks, JVM/Go-Laufzeit-Tuning
ImagePullBackOff / ErrImagePull ECR/GHCR/ACR Auth, IAM-Rollen, Bild-Tag-Tippen
Pending / Unschedulable Ressourcenquoten, Node-Selectoren, Taints/Tolerations, PVC-Bindung
Helm-Fehler Chart-Abhängigkeitsfehler, Value-Schema-Abweichungen, Template-Fehler, Release-Blockade
Networking CNI (Calico/Cilium/Flannel), CoreDNS, Service/Ingress 502/504, NetworkPolicy
ConfigMap/Secret Probleme fehlende Keys, falsches Namespace, SubPath-Mounts, Finalizer
Probe-Fehler Liveness/Readiness/Startup-Tuning, HTTP vs. Exec vs. gRPC
HPA/VPA skaliert nicht, metrics-server, benutzerdefinierte Metriken, Ressourcen vs. External Metrics


Automatische Übersetzung
Wie greifst du sicher auf mein Cluster zu?
Du gibst bereit: kubeconfig mit eingeschränktem RBAC (get/list/watch pods, logs, events, helm-Releases) ODER Cloud-Console-Zugang (EKS: aws eks update-kubeconfig, GKE: gcloud container clusters get-credentials, AKS: az aks get-credentials). Ich frage nie nach Admin-/Root-Zugriff.
Was, wenn das Problem in meinem Anwendungs-Code steckt?
Ich identifiziere es (Stack-Trace, Exit-Code, Logs) und sage dir genau, was du fixieren musst. Wenn du willst, dass ich das Container-Image patche, ist das ein separater Scope (schreib mir eine Nachricht).
Kannst du Helm-Charts reparieren, die jemand anderes geschrieben hat?
Ja. Ich debugge die Release (helm status, helm get values, helm template), behebe Werte/Abhängigkeiten/Templates und teste mit helm upgrade --dry-run --debug.
Arbeitest du auch am Wochenende/Nachts bei Produktionsnotfällen?
Ja. Schreib mir mit "URGENT" + Zeitzone. Ich antworte in weniger als 30 Minuten während der Wachzeiten (UTC+3). Notfallaufschlag: +50% (Basis), +30% (Standard/VIP).