Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
CVAT-Experte für Bild- und Videolabeling
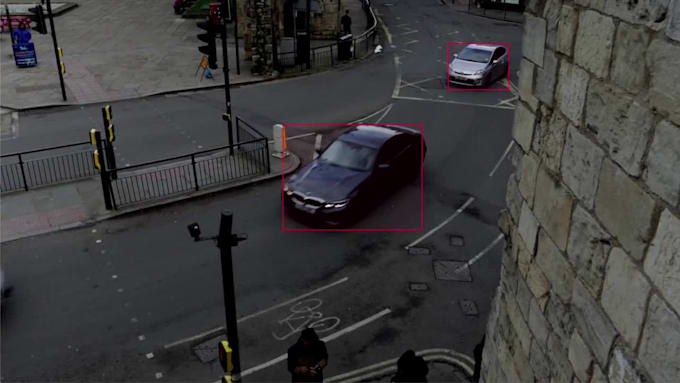
Benötigst du präzise Labels für dein Computer-Vision-Modell? Ich annotiere Bilder und Videos mit CVAT, genau nach deinen Vorgaben.
WAS ICH MACH
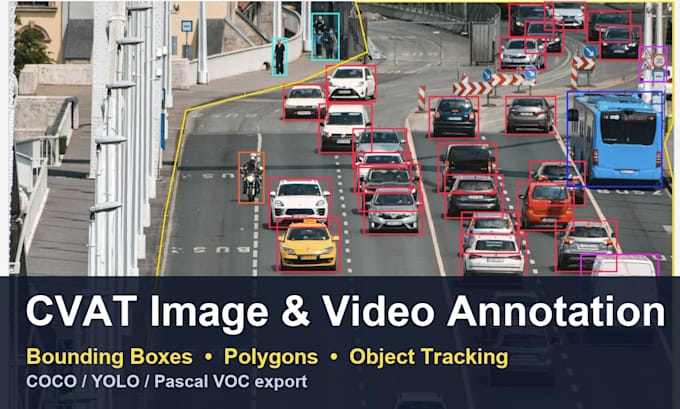
- Bounding Boxes zur Objekterkennung (Fahrzeuge, Personen, Schilder, Produkte)
- Polygone zur Segmentierung (Straßen, Objekte, Regionen)
- Polylinien, Keypoints, Ellipsen und Würfel
- Video-Objektverfolgung mit konsistenten IDs, Keyframes und Interpolation
- Export in CVAT-, COCO-, YOLO- oder Pascal VOC-Format
WARUM ICH
- Abschluss in Informatik und Hintergrund in Softwareentwicklung
- Enge Boxes, die jeden sichtbaren Teil jedes Objekts abdecken
- Zweite Prüfung bei jedem Batch, um verpasste Objekte und inkonsistente Labels zu finden
- Klare Kommunikation und pünktliche Lieferung
WIE ES FUNKTIONIERT
1. Schreibe mir eine Nachricht mit einigen Beispielbildern und deiner Label-Liste oder Richtlinien
2. Ich bestätige den Umfang und das passende Paket für dich
3. Du erhältst saubere, geprüfte Annotationen im gewählten Format
Nicht sicher, welches Paket passt? Schreib mir vor der Bestellung, dann empfehle ich dir eines.


Technik:
Anleitung
Tagging-Typ:
Bild
•
Video
Automatische Übersetzung
Welche Formate kannst du liefern?
CVAT XML, COCO JSON, YOLO oder Pascal VOC. Sag mir, welches Format dein Modell verwendet.
Kann ich zuerst ein paar Bilder senden?
Ja. Schreibe mir 3–5 Beispielbilder und deine Richtlinien, dann bestätige ich den Umfang, bevor du bestellst.