Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
ML-Ingenieur: Modelle mit ehrlichen Metriken
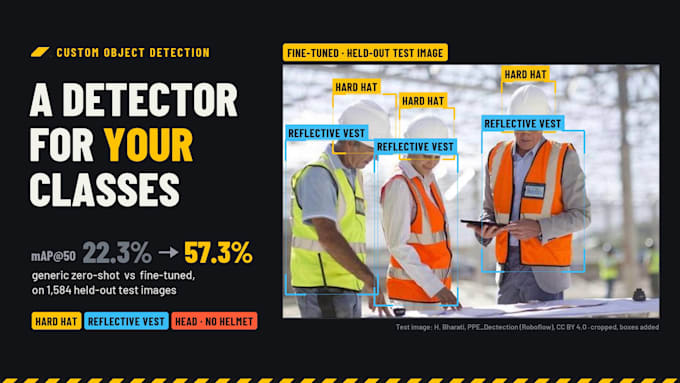
Generische Erkenner übersehen oft die Dinge, die deinem Geschäft wichtig sind. Ich trainiere einen Objekterkenner auf deinen eigenen Klassen (Produkte, Defekte, Geräte, Sicherheitsausrüstung, alles, was du labeln kannst) und beweise, wie gut er funktioniert, bevor du dich darauf verlässt.
Mit dem Paket erhältst du einen feinabgestimmten Erkenner, der auf einem Modell mit einer permissiven Lizenz basiert, in ONNX exportiert, sodass er auf CPU oder GPU läuft, eine kleine Inferenz-API und einen klaren Bericht: die AP pro Klasse mit 95% Konfidenzintervallen auf einem ausgesonderten Testset, einen Vergleich mit einem fertigen Zero-Shot-Erkenner und echte Beispiele seiner Fehler.
In meinem Beispielprojekt (Helm, reflektierende Westen und Köpfe ohne Helm) stieg der mAP@50 von 22,3% mit dem generischen Erkenner auf 57,3% nach Feinabstimmung, gemessen an 1.584 ausgesonderten Testbildern. Der ONNX-Export entsprach dem Originalmodell auf dem gesamten Testset. Es ist ein Konzeptprojekt, daher hängen deine Ergebnisse von deinen Bildern und Labels ab.
Ich prüfe zuerst die Datenqualität: Duplikate, undurchsichtige Trainings-/Testaufteilungen und unklare Labels sind die üblichen Gründe, warum ein Erkenner in einer Demo großartig aussieht und im echten Einsatz versagt.
Bitte sende gelabelte Bilder im COCO-, YOLO- oder Pascal VOC-Format oder teile mir mit, was du hast, und wir planen die Labeling-Arbeit.


Programmiersprache:
Python
Frameworks:
PyTorch
Automatische Übersetzung
Welches Modell verwendest du?
Ich wähle ein Modell mit einer permissiven Lizenz (das Beispiel nutzt einen Apache-2.0-Erkenner), damit du es kommerziell integrieren kannst, ohne Überraschungen durch Copyleft. Wenn du eine andere Familie möchtest, sag mir das vor der Bestellung, und ich prüfe die Lizenzbedingungen.
Wie viele Bilder brauche ich?
Mehr ist besser; einige hundert gelabelte Bilder pro Klasse sind ein vernünftiger Anfang. Ich sage dir nach einem Blick auf eine Probe, ob das reicht.
Funktioniert es mit meinen Kameras?
Der Bericht basiert auf deinen eigenen ausgesonderten Bildern. Eine neue Seite oder Kamera braucht eine eigene Validierung vor dem echten Einsatz, und ich werde das im Bericht so angeben.
Kann es Personen erkennen oder die Einhaltung prüfen?
Nein. Ich baue Erkenner für Objekte und Regionen; Systeme, die Personen identifizieren oder disziplinarische Entscheidungen treffen, entwickle ich nicht.