Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden

Automatische Übersetzung
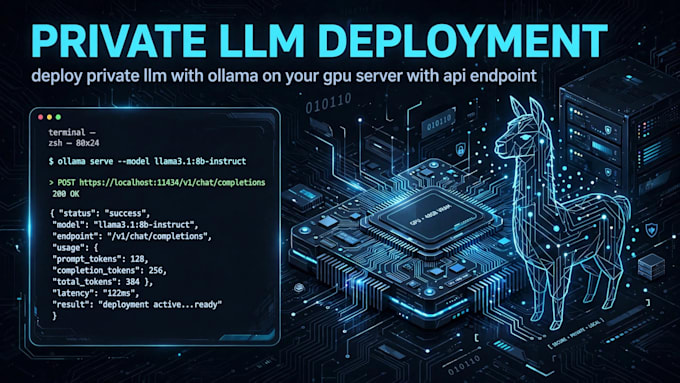
Willst du dein eigenes privates KI-Modell, das 24/7 läuft? Ich installiere Ollama (oder llama.cpp) auf deiner GPU-Cloud-Instanz, lade das gewünschte Modell und stelle es als OpenAI-kompatiblen API-Endpunkt bereit – optional mit einer Web-Chat-Oberfläche.
Was du bekommst:
- Ollama / llama.cpp installiert und auf deiner GPU-Instanz optimiert
- Modell deiner Wahl geladen und einsatzbereit
- OpenAI-kompatibler API-Endpunkt für deine Apps
- Optional: Open WebUI-Chatoberfläche
- GPU-Mietberatung, falls du noch keinen Server hast (du mietest in deinem eigenen Konto, ich empfehle die günstigste Option für dein Modell und Budget)
Was ich von dir brauche:
- Zugriff auf die GPU-Instanz (SSH-Login)
- Welches Modell du laufen lassen willst (oder deinen Use Case – ich empfehle eines)
Python Developer , Web Scraping and Automation Specialist
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Brauche ich meinen eigenen GPU-Server?
Ja – du mietest die GPU-Instanz in deinem eigenen Konto (RunPod, Vast.ai, etc.). Ich empfehle die günstigste Option für dein Modell und Budget, dann installiere und konfiguriere alles.
Welche Modelle kannst du bereitstellen?
Jedes Modell, das Ollama oder llama.cpp unterstützt – Llama, Qwen, Mistral, DeepSeek-Distills und mehr. Sag mir deinen Anwendungsfall und ich empfehle dir eines.
Können meine Apps das Modell über API nutzen?
Ja – ich stelle einen OpenAI-kompatiblen Endpunkt bereit, sodass alles, was mit der OpenAI-API funktioniert, auch mit deinem privaten Modell funktioniert.
