Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD


Automatische Übersetzung
Manuelles Kopieren von Daten aus Rechnungen, Formularen, Quittungen oder gescannten Dokumenten ist langsam und fehleranfällig. Ich entwickle KI-gestützte Extraktionssysteme, die deine Dokumente lesen und automatisch in saubere, strukturierte Daten umwandeln.
Ich nutze APIs großer Sprachmodelle in Kombination mit Dokumentenparsing, um spezifische Felder aus PDFs, gescannten Bildern und Formularen zu extrahieren und die Ergebnisse als JSON, CSV oder direkt in deine Datenbank auszugeben. Dieser Ansatz versteht den Kontext, sodass er unterschiedliche Layouts, Handschriften oder inkonsistente Formatierungen besser verarbeitet als einfache OCR.
Wofür das hilfreich ist: Rechnungs- und Quittungspositionen, Bewerberdaten aus Lebensläufen, strukturierte Daten aus Verträgen oder Berichten und saubere Daten in deine bestehenden Systeme einspeisen.
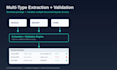
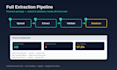
Ich bin ein erfahrener Full-Stack-Entwickler mit Produktionserfahrung beim Aufbau einer Dokumentenmanagement-Plattform für die Bankenbranche. Ich erstelle Extraktionspipelines mit Validierung und Fehlerbehandlung, nicht nur eine einzelne API-Anfrage.
So funktioniert es: sende 3-5 Muster-Dokumente, ich entwickle und teste die Extraktionslogik daran, und liefere dir das funktionierende System mit Dokumentation.
Hinweis: Die Genauigkeit hängt von der Qualität der Dokumente ab. Ich werde vor Beginn markieren, wenn Dokumente zu stark beschädigt sind, um zuverlässig extrahiert zu werden.
Software Engineer
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Welche Dateiformate unterstützen Sie?
PDFs, gescannte Bilder (JPG/PNG) und die meisten gängigen Dokumentenformate. Bei handschriftlichen Dokumenten kann die Genauigkeit variieren, und ich werde dich vorab informieren, wenn eine Probe schwierig aussieht.
Welche AI-Technologie nutzt du?
Ich nutze führende APIs großer Sprachmodelle (wie die von Anthropic und OpenAI) in Kombination mit Dokumentenparsing-Tools, die je nach deinen Genauigkeits- und Budgetanforderungen ausgewählt werden.
Kannst du das in mein bestehendes System integrieren?
Ja, das ist im Premium-Paket enthalten. Für Basic und Standard liefere ich die Extraktionslogik und das Ausgabeformat, die Integration kann als individuelles Angebot besprochen werden.
Meine Dokumente haben inkonsistente Layouts, kannst du das trotzdem machen?
Oft ja, da ich auf LLM-basierte Extraktion setze, die besser mit Layout-Variationen umgeht als starres Template-Matching, das bei traditionellem OCR üblich ist. Schick mir Muster, und ich bestätige vor Beginn.
Werden meine Daten vertraulich behandelt?
Ja. Ich speichere oder wiederverwerte deine Dokumente nicht über den Projektumfang hinaus. Sag mir Bescheid, wenn du vor dem Teilen sensibler Dateien eine NDA brauchst.


