Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Automatische Übersetzung
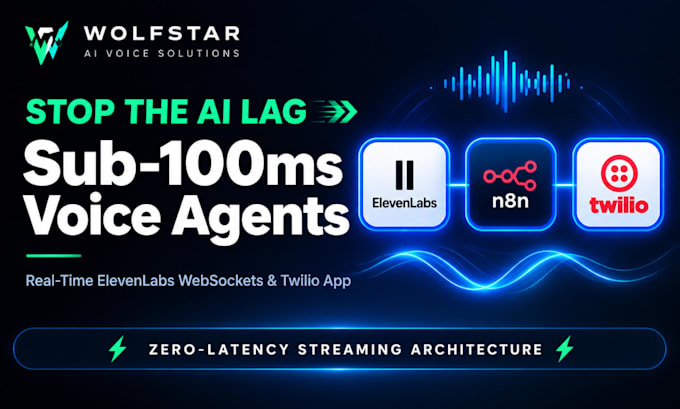
Ruiniert eine langsame, verzögerte 4-Sekunden-Verzögerung dein Erlebnis mit dem AI-Sprachagenten? Scheitern deine Sprachbots bei der Ausführung von Echtzeitaktionen während Live-Telefonaten?
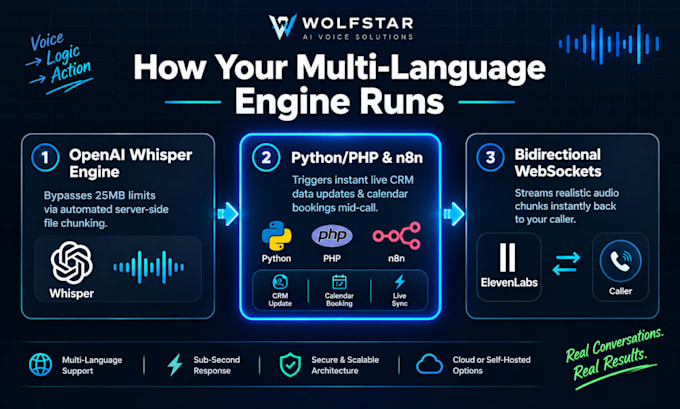
Mit maßgeschneidertem 11Labs Whisper Python/PHP-Backend-Code, fortschrittlicher Serverarchitektur liefere ich Sprachagenten ohne Verzögerung, die Datenbankvariablen lesen, CRM live während des Anrufs aktualisieren und große Datensätze ohne die üblichen API-Limits verarbeiten können.
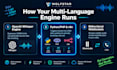
Fortschrittliche technische Architektur, die du bekommst:
WebSockets-Streaming unter 100 ms
Umgehung des Whisper 25MB-Limits
Live Mid-Call Funktionsaufrufe
Phonetische Injection-Pre-Processing
Kontaktiere mich!
Software Engineer With Ai Dev Mobile App website dev bot VA Ai voice agents
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Wie erreichst du eine Antwortlatenz unter einer Sekunde?
Anstatt auf vollständige Sätze zu warten, baue ich bidirektionale WebSocket-Verbindungen in Python oder Node.js. Diese streamen Audio-Pakete gleichzeitig hin und her und senken die Latenz auf unter 1,5 Sekunden.
Wie umgehst du das 25MB-Dateilimit von OpenAI Whisper?
Ich erstelle einen automatisierten serverseitigen Dateihandler mit FFmpeg. Wenn eine große Audiodatei hochgeladen wird, schneidet das Skript sie in optimierte, überlappende 20MB-Chunks, übergibt sie gleichzeitig an Whisper und fügt die Transkripte nahtlos zusammen.
Was ist Mid-Call-Funktionsaufruf?
Es ermöglicht dem AI-Sprachagenten, während des Gesprächs mit deiner Software zu interagieren. Wenn ein Kunde seinen Termin ändern möchte, löst der Agent einen Live-Hintergrund-Webhook aus, um deine Datenbank sofort während des Anrufs zu aktualisieren.
Wie verhinderst du, dass die KI Branchenbegriffe oder Firmennamen falsch ausspricht?
Ich implementiere eine maßgeschneiderte Text-Pre-Processing-Skript-Schicht. Bevor der Text an die ElevenLabs API gesendet wird, werden spezielle Fachbegriffe oder Abkürzungen systematisch in phonetische Schreibweisen umgeschrieben, um die korrekte Aussprache zu erzwingen.
Kann dieses Setup vollständig selbst gehostet werden?
Ja! Wenn du wiederkehrende API-Token-Gebühren vermeiden möchtest, kann ich dir helfen, Dockerisierte, selbstgehostete Whisper-Container direkt in deiner eigenen Serverumgebung zu konfigurieren, um unbegrenzte Audio-Text-Konvertierungen kostenlos durchzuführen.
Brauche ich ein n8n Cloud-Konto oder können wir eine selbstgehostete Instanz verwenden?
Beides funktioniert perfekt. Ich kann deine Workflows auf einem n8n Cloud-Konto bereitstellen oder eine selbstgehostete n8n-Instanz auf deinem VPS (wie DigitalOcean oder AWS) einrichten, um maximale Sicherheit zu gewährleisten und monatliche Workflow-Limits zu eliminieren.
Kann dein Streaming-Agent plötzliche Nutzerunterbrechungen handhaben?
Ja. Ich optimiere die Voice Activity Detection (VAD)-Endpunkt-Matrizen. Sobald der Server erkennt, dass der Mensch spricht, stoppt die Streaming-Audio-Pipeline sofort, um auf die neue Eingabe zu hören.
Welche Datenbank-Frameworks unterstützt du nativ?
Ich verbinde Sprach-Apps routinemäßig mit PostgreSQL, MongoDB, MySQL, Firebase und Cloud-CRM-Tabellen (wie Airtable, GoHighLevel und HubSpot Hubs) über native Backend-Integrationen.
Funktioniert das System mit benutzerdefinierten Voice-Clones, die ich bereits erstellt habe?
Absolut. Wir speisen deine spezifische ElevenLabs Voice ID direkt in unsere WebSocket-Streaming-Parameter ein, und das System läuft sofort mit deinem benutzerdefinierten Voice-Clone.
Wird die geklonte Stimme natürlich klingen, wenn sie vom Englischen in Sprachen wie Spanisch, Arabisch, Kreolisch, Mandarin, Schwedisch, Portugiesisch usw. übersetzt wird?
Absolut. Durch die Nutzung der fortschrittlichen mehrsprachigen Modelle von ElevenLabs behält die Stimme ihre Grundstimmung, Altersmerkmale und Gesprächsintonierungen bei, während sie die nativen Akzentregeln übernimmt.