Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Ich erstelle Automatisierungen, die Zeit sparen und manuelle Arbeit reduzieren
Level 1
Hat bestimmte Leistungskriterien erfüllt und zeigt großes Potenzial auf dem Marktplatz.
Ich werde eine automatisierte Datenpipeline bauen, die deine Geschäftsdaten sammelt, bereinigt, transformiert und dorthin schickt, wo sie hin sollen.
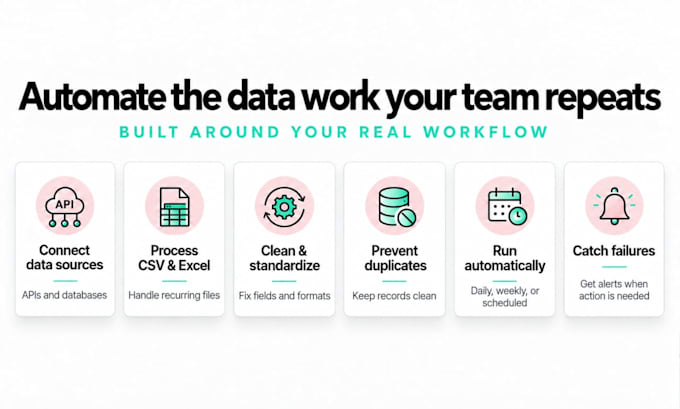
Ich kann mit APIs, CSV, Excel, JSON, PostgreSQL, MySQL, Supabase, Cloud-Speicher und anderen kompatiblen Systemen arbeiten.
Je nach Paket kann deine Pipeline folgendes umfassen:
Datenextraktion und API-Verbindungen
Bereinigung, Mapping, Filterung und Duplikatentfernung
Validierung und Datenqualitätsprüfungen
Geplante automatische Abläufe
Fehlerprotokollierung und Fehlerbenachrichtigungen
Tests, Dokumentation und Deployment
Dieser Service ist ideal für wiederkehrende Datenaufgaben, Reporting-Workflows, Datenbank-Updates und System-zu-System-Datenübertragungen.
Bitte schreibe mir vor der Bestellung eine Nachricht mit deiner Datenquelle, deinem Ziel, Beispiel-Daten und dem Prozess, den du automatisieren möchtest, damit ich das richtige Paket bestätigen kann.


Tools und Plattformen:
Andere
Automatische Übersetzung
Was ist eine Datenpipeline oder ETL-Pipeline?
Es ist ein automatisierter Prozess, der Daten aus einer Quelle sammelt, bereinigt oder transformiert und an ein anderes System sendet. Zum Beispiel: API → Daten bereinigen und validieren → PostgreSQL.
Mit welchen Datenquellen können Sie arbeiten?
Häufige Quellen sind REST-APIs, CSV, Excel, JSON, PostgreSQL, MySQL, Supabase, Cloud-Speicher und andere Systeme mit zugänglichen APIs oder Datenbankverbindungen.
Kann die Pipeline automatisch laufen?
Ja. Standard- und Premium-Pakete können geplante Abläufe wie stündliche, tägliche oder wöchentliche Verarbeitung enthalten.
Kannst du meine Daten bereinigen, kombinieren oder transformieren?
Ja. Das kann das Umbenennen von Feldern, Formatieren von Daten, Filtern von Datensätzen, Entfernen von Duplikaten, Verbinden von Datensätzen, Konvertieren von Werten und Anwenden von Geschäftsregeln umfassen.
Kannst du eine API mit meiner Datenbank verbinden?
In der Regel ja. Bitte sende mir vor der Bestellung die API- und Ziel-Details, damit ich Zugriff und Machbarkeit bestätigen kann.
Was passiert, wenn die Pipeline fehlschlägt?
Je nach Paket kann ich Protokollierung, Validierung, Fehlerbenachrichtigungen, Wiederholungslogik und andere Fehlerbehandlungsmaßnahmen einbauen.
Erhalte ich den Quellcode und die Dokumentation?
Ja. Der vereinbarte Quellcode und die Setup-Dokumentation sind enthalten, sodass du nicht an die Lieferung gebunden bist.
Welche Projekttypen sind in diesen Paketen nicht enthalten?
Große Unternehmensdatenlager, Spark- oder Databricks-Architekturen, Kafka-Streaming, größere Migrationen und andere komplexe Data-Engineering-Systeme erfordern eine separate Planung und ein individuelles Angebot.
Soll ich Sie vor der Bestellung kontaktieren?
Ja. Bitte schreibe mir zuerst mit deiner Datenquelle, deinem Ziel, Beispiel-Daten und gewünschtem Workflow, damit ich das richtige Paket und den Umfang bestätigen kann.