Kategorien durchsuchen
Deutsch
$
USD
Verbinden Sie sich mit Ihrer KI
Full Stack, Backend und Data Engineer
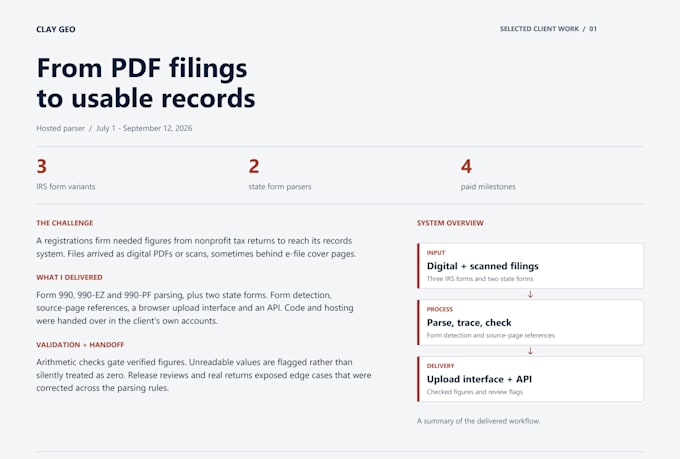
Digitale PDFs und gescannte Formulare in strukturierte Daten verwandeln, die dein Team nutzen kann.
Ich erstelle wiederverwendbare Python-Extraktions-Workflows für festgelegte Dokumentenlayouts, mit CSV- oder JSON-Ausgabe sowie Checks auf fehlende oder ungültige Felder. Ein abgeschlossenes Kundenprojekt umfasste einen maßgeschneiderten PDF-Daten-Parser.
Basis deckt ein digitales PDF-Layout ab. Standard ergänzt OCR für überprüfte gescannte Dokumente. Premium fügt weitere Layouts und einen Extraktions-API-Endpunkt für deine Anwendung hinzu. Jedes Paket enthält Quellcode, Beispielausgabe, Referenzen zu Quellenseiten, Validierungskennzeichen und Setup-/Übergabehinweise.
Ich prüfe zunächst repräsentative Muster, stimme die Felder und erwarteten Ergebnisse ab und teste dann den Parser an diesem Samplesatz. OCR-Ergebnisse hängen von der Dokumentenqualität ab; der Workflow kennzeichnet erkannte Ausnahmen zur Prüfung.
Pakete decken die angegebenen Layouts, die Gesamtfelderzahl und die ersten Testseiten ab. Sende Beispieldokumente und dein gewünschtes Ausgabeformat vor der Bestellung. Größere Archive, komplexe Tabellen, stark variable Layouts oder zusätzliche Integrationen können separat angeboten werden. Hosting- und Drittanbieter-Verarbeitungsgebühren sind separat zu berücksichtigen.


Technologie:
Python
Automatische Übersetzung
Was zählt als Layout oder als Feld?
Ein Layout ist eine konsistente Dokumentenvorlage. Ein Feld ist eine Ausgabespalte oder ein JSON-Schlüssel; Feldgrenzen beziehen sich auf das gesamte gemäß dem vereinbarten Schema. Komplexe Tabellen oder größere Template-Variationen benötigen eine separate Prüfung.
Kannst du gescannte PDFs und Handschrift verarbeiten?
Standard und Premium beinhalten OCR für überprüfte Scans. Handschrift, stark beschädigte Seiten und stark variable Layouts benötigen eine Musterprüfung und können einen individuellen Leistungsumfang erfordern.
Wie prüfst du die Extraktionsqualität?
Ich vergleiche die Ausgabe mit den vereinbarten Musterwerten und berichte die Ergebnisse. Fehlende oder ungültige Werte erhalten Validierungskennzeichen. OCR kann Fehler machen, deshalb verspreche ich keine perfekte Genauigkeit.
Was ist in Lieferung und Revisionen enthalten?
Quellcode, Beispielausgabe, Quellenseiten-Verweise, Validierungskennzeichen und Setup-Hinweise. Premium fügt einen API-Endpunkt hinzu. Revisionen verfeinern die vereinbarte Extraktion; neue Layouts, Felder oder Integrationen fallen unter zusätzlichen Leistungsumfang.