Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Senior Data AI Profi
Unordentliche Webseiten, Feeds oder Instagram-Accounts werden in eine saubere, deduplizierte Tabelle umgewandelt, die du abfragen kannst, regelmäßig aktualisiert wird, mit einem Dashboard oder API oben drauf.
Der Unterschied zu einem einfachen Scraper: ein KI-Schritt liest jeden Eintrag und füllt Felder aus, die Regexes nicht erfassen können, wie Kategorie, Preisspanne, Stimmung, Entitäten oder das Veranstaltungsdatum im Bildtext. Das Ergebnis wird vor der Speicherung im Schema validiert, damit fehlerhafte Antworten laut scheitern, anstatt deine Daten zu verunreinigen.
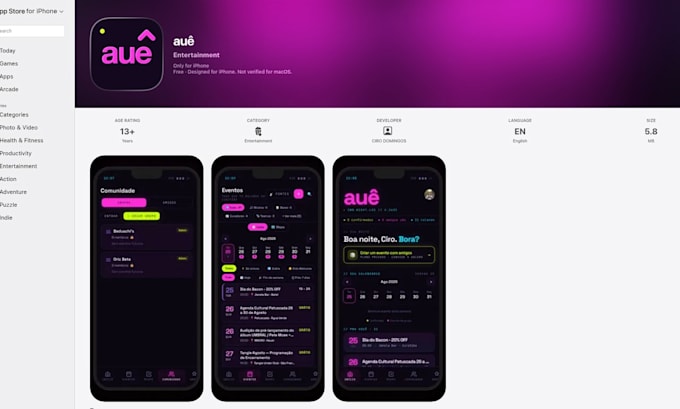
Beweis: Meine Events-App zieht täglich etwa 80 Instagram-Accounts durch Apify und nutzt Claude, um Event-Felder aus Posts und Bildern zu extrahieren. Mein Marken-Scraper macht dasselbe für Markenattribute. Beide Links findest du in meinem Profil.
Was du bekommst: die Pipeline, die auf Railway oder deinem Server läuft, die Tabelle in SQLite oder Postgres, ein Streamlit-Dashboard oder einen FastAPI-Endpunkt und die Kosten jeder Ausführung werden aufgezeichnet.
So starten wir: schick zwei Beispielseiten und die gewünschten Spalten. Du erhältst eine Muster-Tabelle mit 100 Zeilen vor der vollständigen Ausführung.
Nicht enthalten: Seiten, die Scraping in ihren Nutzungsbedingungen verbieten, Logins, Captchas.
Technologie:
Python
•
Google Sheets
•
Selen
•
Dramatiker
•
Pandas
Technik:
Automatisiert
Automatische Übersetzung
Kann es auf meinem Server laufen?
Ja, oder auf Railway unter deinem Konto.
Was kostet der Betrieb?
In der Regel unter 20 Dollar im Monat; jeder Lauf protokolliert seine Kosten.