Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
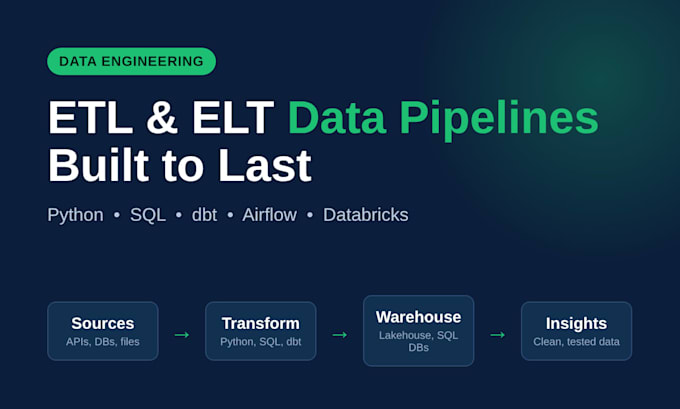
Data Engineer für ETL- und ELT-Pipelines, SQL, Python, dbt, Databricks
Braucht du zuverlässige Datenpipelines, die rohe Daten in saubere, analysebereite Tabellen verwandeln? Ich bin Data Engineer (Top Rated bei Upwork, 100 % Joberfolg, über 1000 Stunden) und baue ETL/ELT-Pipelines, die getestet, dokumentiert und leicht zu pflegen sind.
WAS DU BEKOMMST
MEIN PROZESS
Nicht sicher, welches Paket passt? Schreibe mir vor der Bestellung und ich empfehle den passenden Umfang.
Automatische Übersetzung
Mit welchen Tools und Plattformen arbeiten Sie?
Python, SQL, dbt, Apache Airflow, PySpark und Databricks, mit PostgreSQL und anderen relationalen Datenbanken. Ich integriere auch APIs, Flat Files und Cloud Storage. Sag mir deine Stack-Konfiguration, und ich arbeite damit.
Was erhalte ich bei der Lieferung?
Gut kommentierter Quellcode, eine kurze README mit Setup- und Run-Anleitung sowie eine Einführung, wie die Pipeline funktioniert. Standard- und Premium-Pakete enthalten außerdem eine anfängliche Datenprüfung und Design-Empfehlungen.
