Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Dateningenieur
Ich helfe Unternehmen dabei, zuverlässige Datenpipelines zu erstellen, die Datenaufnahme zu automatisieren und Rohdaten in analytics-ready Datensätze zu transformieren.
Mein Dienstleistungsumfang umfasst:
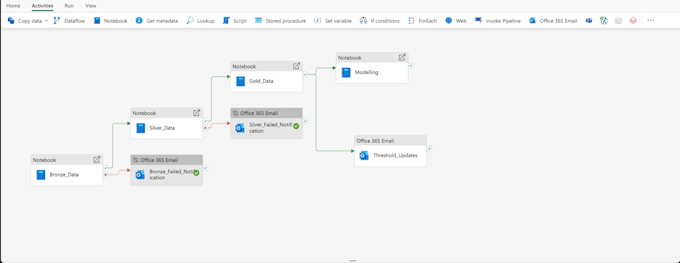
ETL/ELT-Pipeline-Entwicklung
Google BigQuery SQL-Transformationen und geplante Abfragen
Microsoft Fabric-Datenpipelines und Lakehouse-Workflows
Python-API-Integrationen und Datenaufnahme
Datenbereinigung, Validierung und Qualitätsprüfungen
Datenmodellierung und Abfrageoptimierung
Pipeline-Debugging und Dokumentation
Ich habe praktische Erfahrungen mit Cloud-Datenworkflows, API-Integrationen, geplanten Abfragen und Daten-Transformationen. Mein Fokus liegt darauf, saubere, wartbare Lösungen zu bauen, die manuellen Aufwand reduzieren und die Datenverlässlichkeit verbessern.
Mein Prozess:
Egal, ob du eine neue Pipeline brauchst, Hilfe beim Fixen eines bestehenden Workflows suchst oder automatisierte Datenverarbeitung wünschst – ich liefere eine Lösung, die auf deine Bedürfnisse zugeschnitten ist.
Schreibe mir bitte vor der Bestellung, damit wir deine Anforderungen, den Umfang und die erwarteten Deliverables besprechen können.
Warehouse-Plattform:
BigQuery
•
Fabric Warehouse
•
Databricks
Projektart:
New Build
Automatische Übersetzung
Könntest du kurz erklären, was du von mir brauchst?
Die Datenquellen, Geschäfts-Transformationen und wie die transformierten Daten dem Geschäft nützen.
