Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Kreativer Autor, Lektor und Kollaborateur
Kopierst du ein mehrspaltiges PDF hinein, kommen die Spalten durcheinander. OCR macht das Gleiche. Das ändere ich: Deine PDF-Daten landen in einer Tabelle in der Reihenfolge, wie sie ein Mensch liest.
Ich spezialisiere mich auf PDFs, die andere Tools aus dem Gleichgewicht bringen: alte oder veraltete Dokumente, Mehrspalten-Layouts, gescannte Seiten und Tabellen, die sich über Seiten erstrecken.
Was ich erledige:
- Mehrspalten-Layouts werden in echter Lese-Reihenfolge gelesen, nicht in wirren Zeilen
- Gescannte/PDFs via OCR
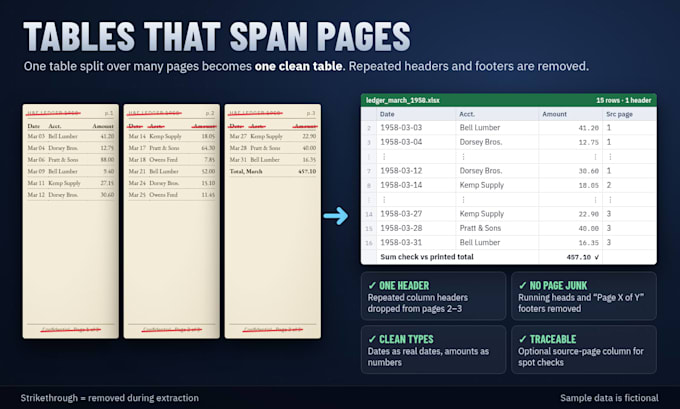
- Tabellen, die sich über Seiten erstrecken, zu einer einzigen Tabelle zusammengeführt und wiederkehrende Kopf- und Fußzeilen entfernt
- Hunderte Dateien im Batch in dieselben konsistenten Spalten gebracht
- Rechnungen, Auszüge, Berichte, Kataloge, Preislisten, Legacy-Daten
Keine stillen Fehler: Jedes Projekt durchläuft Validierungsprüfungen (Zeilenanzahl, Summen, Datum). Alles, was unklar ist, wird zur manuellen Prüfung markiert statt geraten zu werden.
Du bekommst: sauberes CSV und/oder Excel, eine kurze Genauigkeitsnotiz und im Premium-Paket ein wiederverwendbares Script, damit du künftige Stapel selbst laufen lassen kannst.
Ehrliche Offenlegung: Ich setze Python-Automatisierung ein und bei unübersichtlichen Scans OCR und KI-gestützte Extraktion. Ich überprüfe das Ergebnis. Willst du kein AI nutzen, sag mir vor der Bestellung Bescheid.
Vertraulich, auf Wunsch gelöscht. Keine Dokumentenfälschung.
Technologie:
Excel
•
Google Sheets
•
Python
Automatische Übersetzung
Warum kommen meine PDFs durcheinander heraus, wenn ich sie kopiere oder per OCR verarbeite?
Mehrspalten-PDFs und ältere PDFs speichern Text in Layout-Reihenfolge, nicht in Lese-Reihenfolge, daher vermischen Werkzeuge die Spalten. Ich rekonstruieren die Lese-Reihenfolge, bevor irgendetwas in die Tabelle wandert.
Kannst du gescannte PDFs und Hunderten von Dateien bearbeiten?
Ja. Scans werden per OCR verarbeitet. Große Stapel werden per Script in dieselbe Spaltenanordnung gebracht, damit Datei 1 und Datei 300 übereinstimmen.
Wie stellst du sicher, dass die Daten stimmen?
Automatisierte Validierungschecks prüfen Zeilenanzahl, Beträge und Datum. Alles, was die Checks nicht bestätigen können, wird für die manuelle Prüfung markiert, nicht still raten. Ich behaupte nicht 100% bei unleserlichen Scans.
Wird KI verwendet?
Die Kernarbeit ist Python-Automatisierung. Bei unübersichtlichen Scans kann ich OCR und KI-gestützte Extraktion verwenden, und ich erwähne das in der Liefernotiz. Willst du kein AI, sag mir vor der Bestellung Bescheid; dann nutze ich code-basiert oder manuelle Methoden (Preis kann sich ändern).
Sind meine Daten sicher?
Wird ausschließlich für deine Bestellung verwendet und auf Wunsch gelöscht. Ich werde keine Dokumente verfälschen oder verändern.