Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Automatische Übersetzung
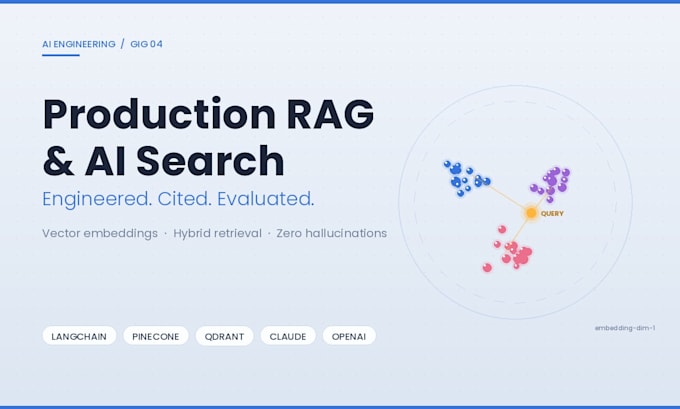
Die meisten "RAG-Chatbots" auf Fiverr werden als Demos geliefert:
ein PDF, schwache Chunking, keine Retrieval-Bewertung, Halluzinationen überall. Ich baue produktionsreife RAG-Systeme, die zitiert, bewertet und überwacht werden.
WAS ICH BAUE:
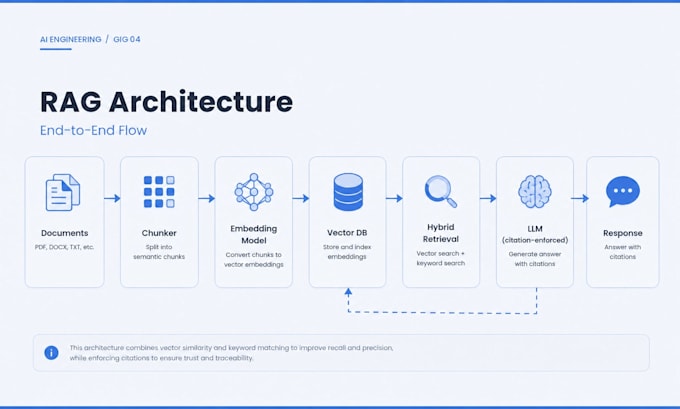
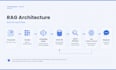
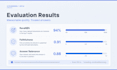
Individuelle RAG-Architektur (LangChain, LlamaIndex oder reines Python) Vektor-Datenbank-Setup (Pinecone, Qdrant, Weaviate, pgvector, Chroma) Intelligentes Chunking + Embedding-Pipeline (OpenAI, Cohere, BGE) Hybride Retrieval-Methoden dicht + sparsam + Neuordnung für tatsächliches Recall@k Zitierpflicht, jede Aussage traceable zu einer Quelle Mehrmodell-Orchestrierung (Claude, GPT-4o/5, Gemini) Bewertungsrahmen (Ragas, eigene Eval-Tools) du weißt, dass es funktioniert Beobachtbarkeit (LangSmith oder eigenes Logging) FastAPI / Node API-Endpunkt bereit für deine App Selbstgehostet (Docker, dein VPS) oder managed (Pinecone)
FÜR WEN ICH BAUE:
SaaS-Gründer, die AI-Suche / Q&A hinzufügen Entwicklerteams, die RAG brauchen, das in Produktion funktioniert Interne Wissensdatenbanken (Notion, Confluence, S3) Startups, die Keyword-Suche durch semantische Suche ersetzen
WARUM DU MICH BEAUFTRAGEN SOLLTEST:
RAG, das nicht halluciniert, bewertet, zitiert, überwacht Sauberes, dokumentiertes Code, den dein Team pflegen kann 1-Stunden-Antwortzeit Schick mir deine Dokumente + Anwendungsfall. Geplanter Umfang in 1 Stunde.
AI Voice Agent Developer, Vapi, Bland AI, Twilio, GPT4o
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Was ist der Unterschied zwischen einem "Demo RAG" und einem "Produktions RAG"?
Ein Demo RAG verarbeitet ein PDF, ruft die Top-k-Chunks ab und fordert ein LLM auf — es funktioniert bei Tutorial-Dokumenten, scheitert aber an echten Daten. Ein Produktions RAG hat intelligentes Chunking, das auf deine Domäne abgestimmt ist, hybrides Retrieval (nicht nur Kosinus-Ähnlichkeit), Neuordnung, Zitierpflicht, Bewertung gegen Ground-Truth Q/
Welche Vektor-Datenbank sollte ich verwenden — Pinecone, Qdrant, Weaviate oder pgvector?
Pinecone ist am schnellsten einsatzbereit (verwaltet, ohne Betrieb) — ideal, wenn du in Tagen liefern willst. Qdrant selbstgehostet ist die beste kostenlose Option, die skaliert. Weaviate ist stark bei hybridem Search mit Metadaten-Filterung. pgvector passt, wenn du bereits Postgres hast und Vektoren neben deinen relationalen Daten möchtest.
Wie verhindert ihr Halluzinationen?
Drei Ebenen. (1) Zitierpflicht — das LLM muss jeden Claim mit der abgerufenen Chunk zitieren, Ausgaben ohne Zitate werden markiert. (2) Retrieval-Validierung — Vertrauenswürdigkeit der Retrieval-Ergebnisse, bei niedriger Vertrauenswürdigkeit antwortet das System mit "Ich habe nicht genug Informationen" statt zu raten. (3) Cross-mo
Kannst du das gesamte System auf meiner Infrastruktur selbst hosten?
Ja. Vollständiges Docker-Compose-Setup: Qdrant oder Weaviate für Vektoren, FastAPI für den Service, deine Wahl des LLM-Endpunkts (OpenAI API, Anthropic API oder selbstgehostetes Llama/Mistral via Ollama oder vLLM). Nützlich, wenn du Compliance-Anforderungen hast oder Vendor Lock-in vermeiden willst. Ab Standard-Tarif inklusive.