Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
PDF zu Text Dokumenten-Konvertierung, durchsuchbare Offline-Bibliotheken
Deine Verträge und technischen Dokumente liegen auf deinem eigenen Rechner. Ein einzelner Klausel zu finden
bedeutet, Dateien nacheinander zu öffnen, und jedes Cloud-Tool, das das löst, schickt deine
Dateien auf die Server von jemand anderem.
Ich baue das Gegenteil: eine durchsuchbare Bibliothek, die komplett auf deinem Computer läuft.
WAS DU BEKOMMST
Keine Installation. Kein Python. Keine GPU. Keine Kommandozeile. Eine .html-Datei, doppelklicken und suchen. Kein Konto, kein Internet.
Jedes Ergebnis zeigt das Quell-Dokument und die Seite, von der es stammt.
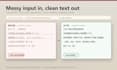
Seitenköpfe, Seitenzahlen und doppelte Zeilen werden entfernt.
WAS ES NICHT TUT
- Keyword-Suche, keine semantische: exakte Codes funktionieren gut, "die Klausel über späte
Zahlung" funktioniert weniger gut.
- Gescannte Seiten brauchen OCR. Saubere Scans sind okay, Handschrift oft nicht.
- OCR-Text kann Fehler enthalten. Gut zum Suchen, nicht zum Zitieren als Autorität.
ZUSÄTZE
- Datenquellenanbindung: Ich verbinde zusätzliche Quellen (Datenbank, Cloud-Drive,
Webseite) in die gleiche Bibliothek.
- API-Integration: fügt eine Frage-und-Antwort-Schnittstelle hinzu, die deinen eigenen API-Schlüssel nutzt.
Deine Dokumente verlassen deinen Rechner trotzdem nie.
- Quellcode enthalten: die Python-Pipeline, die die Bibliothek erstellt, damit du
sie später selbst neu bauen kannst.


Technologie:
Excel
•
Python
•
Andere
Automatische Übersetzung
Muss ich es hosten oder eine Abonnementgebühr zahlen?
Nein. Es ist eine einzelne .html-Datei, die offline geöffnet wird. Nichts wird auf einen Server hochgeladen.
Kannst du Chinesisch?
Ja. Ich habe eine durchsuchbare Bibliothek mit über 5000 chinesischen Artikeln (9,6 Millionen Zeichen) aus gescannten PDFs und Webseiten aufgebaut. Chinesische, englische und japanische Dokumente sind alle kein Problem. (Ich bin Chinese, daher ist das einfach für mich.)
Welche Dateitypen akzeptieren Sie?
Textbasierte PDFs, gescannte PDFs (OCR), Word- und andere Office-Dateien, Klartext und Webseiten. Schick mir eine Probe, und ich bestätige das vor deiner Bestellung.
Ist es wirklich offline? Wohin gehen meine Dokumente?
Nirgendwo. Alles läuft auf deinem Rechner und wird als eine einzelne .html-Datei geliefert. Kein Konto, kein Upload und kein Internet nötig zum Suchen – du kannst das Netz abklemmen und es funktioniert trotzdem.
Kann es Fragen in einfacher Sprache beantworten, wie ein Chatbot?
Nicht in den Standardpaketen – diese bieten Keyword-Suche. Wenn du eine Frage-Antwort-Schnittstelle möchtest, füge das Extra "API-Integration" hinzu: Es nutzt deinen eigenen API-Schlüssel und hält deine Dokumente weiterhin auf deinem Rechner.
Was ist mit gescannten Dokumenten und Handschrift?
Gescannten Seiten werden mit OCR verarbeitet. Saubere, hochauflösende Scans funktionieren gut. Handschrift funktioniert oft nicht, und OCR-Text kann Fehler enthalten – gut zum Suchen, aber nicht zum Zitieren.
Kann ich später weitere Dokumente hinzufügen?
Ja. Mit dem Extra "Quellcode einschließen" bekommst du die Python-Pipeline und kannst die Bibliothek selbst neu aufbauen, wann immer du Dateien hinzufügst. Ohne dieses Extra kannst du mir eine Nachricht schicken, und ich mache dir ein Angebot für eine kleinere Folgearbeit.
Was, wenn mein Set größer als 3000 Seiten ist oder PDFs und Webseiten mischt?
Schick mir eine Nachricht vor der Bestellung. Ich schaue mir deine Dateien an und schicke dir ein individuelles Angebot.