Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD

Agentur
Automatische Übersetzung
CUSTOM LLM FINE-TUNING | PRIVATE AI
Generische KI-Modelle können Fakten aus der Domäne halluzinieren, deinen Geschäftskontext verpassen oder Datenschutzprobleme verursachen.
DIE LÖSUNG
Wir passen Open-Source-LLMs wie Llama 3, Mistral & Qwen an deine proprietären Daten, Workflows und Markenstil an, um spezialisierte Leistung zu erzielen, während deine Daten privat bleiben.
WARUM TKTURNERS
Full-Stack-KI-Engineering mit LoRA/QLoRA, Experten-Datensatzkuratierung, NDA-Konformität und sicherer/air-gapped Datenverarbeitung.
WAS WIR LIEFERN
QUALITÄTSGARANTIE
Wir iterieren, bis das Modell die vereinbarten Benchmark-Metriken erfüllt.
KOSTENLOSER AUDIT
Schreibe uns vor der Bestellung für einen kostenlosen Datensatz-Audit & AI-Architektur-Roadmap.

Agentur
20 Angestellte
Sprachen
Automatische Übersetzung

MEETOVO

S&D Moving

Empowering Confident Youth
Education Services
Automatische Übersetzung
Warum sollte ich Ihnen eine Nachricht senden, bevor Sie eine Bestellung aufgeben?
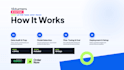
Feinabstimmung hängt stark von der Größe, dem Format und dem Zielanwendungsfall deines Datensatzes ab. Zunächst klären wir, ob deine Daten geeignet sind, und wählen die kosteneffizienteste Open-Source-Architektur.
Wie stellst du sicher, dass meine proprietären Geschäftsdaten vertraulich bleiben?
Deine Daten sind ausschließlich deine. Wir führen Unternehmens-NDA durch, nutzen private air-gapped Rechenumgebungen und löschen alle Trainingsdaten sofort nach Abschluss des Projekts.
Welche Open-Source-Modelle kannst du feinabstimmen?
Wir arbeiten mit Top-Open-Source-Modellen wie Llama 3/3.1, Mistral/Mixtral, Qwen 2.5, Phi-3, Gemma 2 und spezialisierten Code-/Embedding-Modellen.
Wer trägt die Kosten für GPU-Compute und Cloud-Training?
Compute-Kosten (z.B. RunPod, Lambda Labs, AWS EC2 oder Colab Pro) trägt direkt der Kunde. Wir optimieren das Training mit QLoRA, um die Kosten meist unter 10–50 US-Dollar zu halten.
Welches Datenformat muss ich bereitstellen?
Wir akzeptieren JSONL, CSV, Rohtext, Markdown, PDFs oder Instruction-Response-Paare. Wenn deine Daten unstrukturiert sind, können wir sie bereinigen und in hochwertige Instruction-Datasets umwandeln.
In welchem Format wird mein feinabgestimmtes Modell geliefert?
Wir liefern PEFT/LoRA-Adaptergewichte, zusammengeführte safetensors, quantisierte GGUF-Dateien für Ollama/LM Studio oder einen containerisierten vLLM/FastAPI-Service.
Welche Zugriffsrechte benötigst du von mir, um mit der Arbeit zu beginnen?
Wir benötigen dein Muster-/Voll-Dataset und Zugriff auf deine bevorzugte Cloud-GPU-Instanz (RunPod, Hugging Face oder AWS) oder lokale Umgebung.
Was ist bei den Revisionen abgedeckt?
Revisionsarbeiten umfassen Hyperparameter-Anpassungen (Lernrate, Epochen, Rang), erneute Bewertung auf benutzerdefinierten Validierungssets und Formatkonvertierungen.
Kannst du das feinabgestimmte Modell in meine bestehende Web-App oder API integrieren?
Ja. Als Full-Stack-Engineering-Agentur bauen wir FastAPI-Mikroservices, Docker-Container und Next.js/Node.js-Frontends, um dein Modell reibungslos bereitzustellen.
Bieten Sie Support und Wartung nach der Lieferung an?
Ja. Die Premium-Stufe beinhaltet 14 Tage Support. Wir bieten auch laufende Wartungspakete für Retraining, Dataset-Updates und Server-Skalierung an.