Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD

Automatische Übersetzung
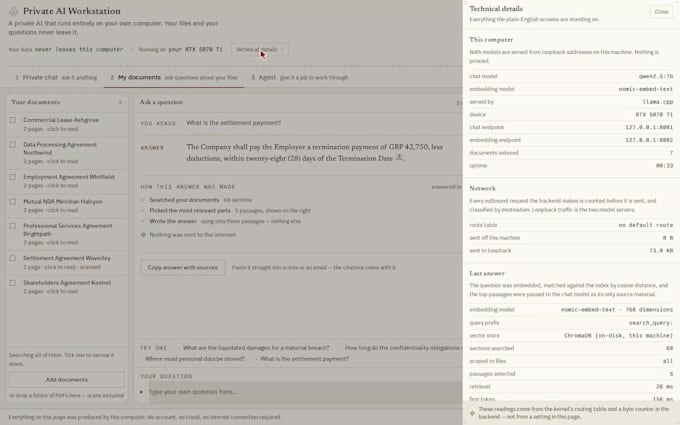
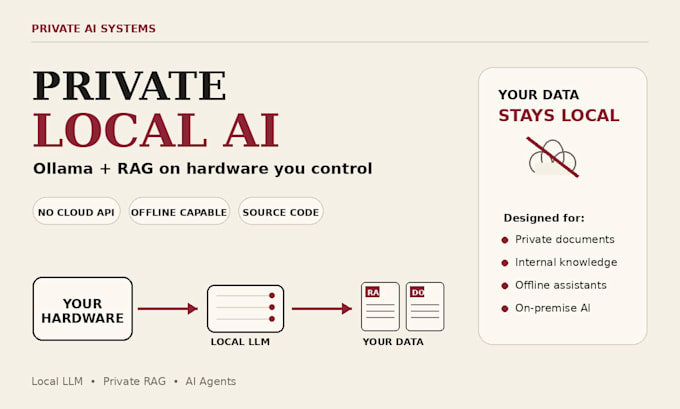
Betreibe ein privates lokales LLM auf Hardware, die du kontrollierst, ohne Eingaben, Dokumente oder sensible Daten an externe Modell-APIs zu senden.
Ich baue lokale KI-Systeme mit Ollama, llama.cpp, RAG, Vektordatenbanken und maßgeschneiderten Agenten-Workflows für Unternehmen und Teams, die Wert auf Privatsphäre legen.
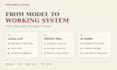
WAS ICH IMPLEMENTIEREN KANN
GEEIGNET FÜR
Interne Wissensdatenbanken, vertrauliche Dokumente, rechtliche/finanzielle Abläufe, private Forschung, Offline-Assistenten und Teams, die wiederkehrende Cloud-KI-API-Kosten vermeiden wollen.
Dein System kann so konfiguriert werden, dass Inferenz und Dokumentenabruf vollständig auf deinem Rechner oder privaten Netzwerk laufen.
Schreib mir vor deiner Bestellung mit deinem Betriebssystem, CPU, GPU/VRAM, RAM und deinem Anwendungsfall, damit ich das passende Modell und Paket bestätigen kann.
Local AI Developer
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Brauche ich einen leistungsstarken Computer, um das auszuführen?
Es kommt auf das Modell und die Arbeitsbelastung an. Für eine schnellere Inferenz wird eine dedizierte NVIDIA-GPU mit ausreichend VRAM empfohlen, aber kleinere Modelle können auch auf CPUs und Apple Silicon Macs laufen. Schick mir deine CPU, GPU/VRAM, RAM und Anwendungsfall, und ich kann dir eine realistische Konfiguration empfehlen.
Benötigt das eine aktive Internetverbindung?
Nach der Installation der benötigten Modelle und Abhängigkeiten ist keine Internetverbindung für das zentrale lokale System erforderlich. Optionale externe Integrationen könnten jedoch Netzwerkzugang benötigen.
Werden meine Prompts und Dokumente an eine externe AI-API gesendet?
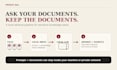
Die Bereitstellung kann so konfiguriert werden, dass Inferenz und Dokumentenabruf auf deinem eigenen Rechner oder privaten Netzwerk laufen, ohne Prompts oder Dokumente an externe Modell-APIs zu senden.
Welche Dokumente kann das RAG-System verwenden?
Typische Quellen sind PDF, DOCX, TXT, CSV und strukturierte Wissensdatenbankinhalte. Frag zuerst nach, wenn du gescannte PDFs, ungewöhnliche Formate oder eine große bestehende Datenbank hast.
Bekomme ich den Quellcode und die Setup-Dateien?
Ja, für individuell erstellten Code für dein Projekt. Drittanbieter-Software und Modelle bleiben ihren eigenen Lizenzen unterworfen. Ich füge auch die vereinbarte Konfiguration und Übergabedokumentation bei.
Kannst du es vollständig air-gapped machen?
Ja, wenn die gewählte Software, Modell-Dateien und deine Umgebung eine air-gapped Bereitstellung unterstützen. Sag mir diese Anforderung vor der Bestellung, damit der Umfang Offline-Abhängigkeitsmanagement einschließt.
Kannst du es auf Windows, Linux, macOS oder einem Server installieren?
Ja, abhängig von deiner Hardware und dem gewählten Stack. Apple Silicon, NVIDIA GPU-Systeme, CPU-only Maschinen und VPS/Server-Setups können mit verschiedenen Modelloptionen unterstützt werden.
Ist Fine-Tuning oder Training im Angebot?
Nein, standardmäßig nicht. Dieses Gig konzentriert sich auf Deployment, RAG, Integration und lokale Agenten-Workflows. Fine-Tuning ist ein separater Umfang und sollte vor der Bestellung besprochen werden.
Wie deploye ich es auf meiner Hardware?
Ich stelle die Projektdateien und Deployment-Schritte bereit und kann die Einrichtung über Fiverr-Kommunikation anleiten. Die genaue Methode hängt von deiner Umgebung und Zugriffsbedingungen ab.
Was soll ich vor der Bestellung senden?
Dein Betriebssystem, CPU, GPU-Modell und VRAM, RAM, verfügbaren Speicher, Anwendungsfall, Dokumenten- und Datentypen, bevorzugte Schnittstelle und ob du Offline- oder air-gapped-Betrieb benötigst.