Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Spezialist für KI und Datenwissenschaft
Möchtest du Rohdaten in intelligente, skalierbare Machine Learning- und Natural Language Processing-Lösungen umwandeln? Du bist hier genau richtig!
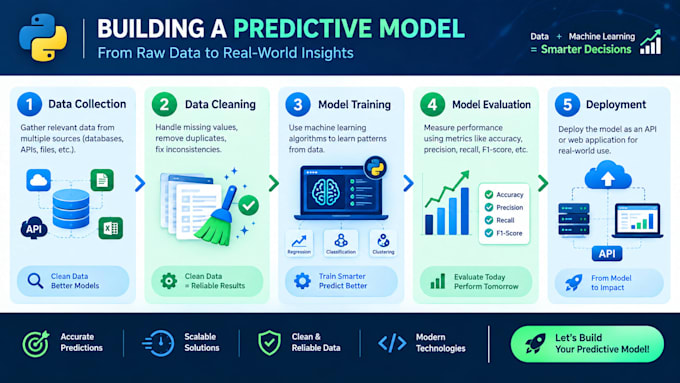
Ich spezialisiere mich darauf, maßgeschneiderte Machine Learning (ML), Natural Language Processing (NLP) und Predictive Models in Python zu bauen, die komplexe Geschäftsprobleme lösen, Aufgaben automatisieren und klare, umsetzbare Einblicke liefern.
Wobei ich dir helfen kann:
Warum du mich wählst?
Bitte kontaktiere mich vor einer Beauftragung.
Programmiersprache:
Python
Frameworks:
scikit-learn
•
keras
•
PyTorch
•
Panda
•
Andere
Tools:
Jupyter-Notizbuch
•
Colab
Automatische Übersetzung
1. Was benötigen Sie, um das Projekt zu starten?
Teile bitte dein Dataset (CSV, JSON, SQL oder Text), deine Projektziele, Zielvariablen und alle konkreten Deadlines oder Leistungsexpectationen.
2. Welche ML- und NLP-Modelle kannst du bauen?
Ich baue traditionelle ML-Modelle (Klassifikation, Regression, XGBoost, Random Forest) und NLP-Modelle (Sentiment-Analyse, Textklassifikation, BERT/LLMs).
3. Kannst du meine Daten bereinigen, vorverarbeiten und vorbereiten?
Ja, ich kümmere mich um den vollständigen Datenvorverarbeitungsprozess, einschließlich Bereinigung fehlender Werte, Feature Engineering, Text-Tokenisierung und Vektorisierung (Embeddings/TF-IDF).
4. Erhalte ich den vollständigen Python-Quellcode?
Ja! Du bekommst sauberen, gut kommentierten Python-Quellcode (Jupyter Notebook oder .py-Dateien) mit jeder Bestellung.
5. Bietest du Modellbewertung und Deployment an?
Ja, ich liefere umfassende Evaluierungskennzahlen (Accuracy, F1-Score, ROC-AUC) und kann Modelle über REST API integrieren oder in die Cloud deployen.