Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD

Automatische Übersetzung
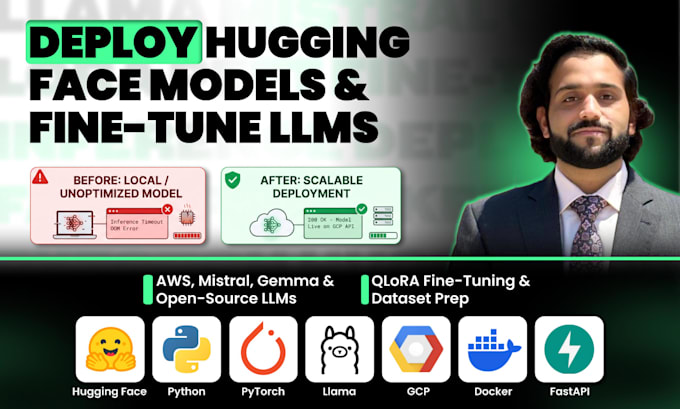
Möchtest du Open-Source-LLMs wie Llama 3, Mistral oder Gemma auf deiner eigenen Cloud-Infrastruktur bereitstellen oder feinabstimmen?
Ich spezialisiere mich auf individuelle Hugging Face Modellintegration, QLoRA-Feinabstimmung, Containerisierung und produktionsreife Deployments auf GCP, AWS und Inference-Endpunkten.
Was ich anbiete:
Technologie-Stack: Hugging Face Transformers, PEFT/LoRA, PyTorch, Llama 3, Mistral, Gemma, GCP Vertex AI, Docker, FastAPI, Python.
Warum du mich wählen solltest?
Bitte schreibe mir vor der Bestellung, um Modellparameter und Cloud-Hosting-Setup zu besprechen!
AI and Machine Learning Engineer
Sprachen
Automatische Übersetzung
Automatische Übersetzung
1. Welche open-source LLMs kannst du feinabstimmen oder bereitstellen?
Ich arbeite mit allen großen open-source Architekturen auf Hugging Face, inklusive Llama 3/3.1, Mistral, Mixtral, Gemma 1/2, DeepSeek, Falcon und Qwen Modellen.
2. Wo kannst du die feinabgestimmten Hugging Face Modelle bereitstellen?
Ich kann deine Modelle auf GCP (Vertex AI, Compute Engine), AWS (SageMaker, EC2), Azure, Hugging Face Inference Endpoints, RunPod oder lokalen GPU-Servern mit Docker-Containern bereitstellen.
3. Welche Feinabstimmungstechniken nutzt du, um Kosten zu reduzieren?
Ich spezialisiere mich auf PEFT-Methoden wie QLoRA und LoRA mit PyTorch und Hugging Face Transformers. Das reduziert den GPU-VRAM-Bedarf und die Trainingskosten erheblich, bei gleichzeitiger hoher Modellleistung.
4. Bekomme ich einen nutzbaren API-Endpunkt, um mein Modell abzufragen?
Ja! Für Standard- und Premium-Pakete verpacke ich das Modell in einen hochleistungsfähigen FastAPI- oder Flask-Webservice mit Endpunkten, die in deine Web-App, Mobile-App oder Backend-Workflow integriert werden können.
5. Wie handhaben wir große Datensatzübertragungen und Cloud-Berechtigungen?
Du kannst deinen Datensatz über sicheren Cloud-Speicher teilen (Google Drive, S3-Bucket, Hugging Face Datasets). Für Cloud-Deployments kannst du temporären IAM-Service-Account-Zugriff gewähren, ohne Root-Account-Passwörter zu teilen.